La versión breve
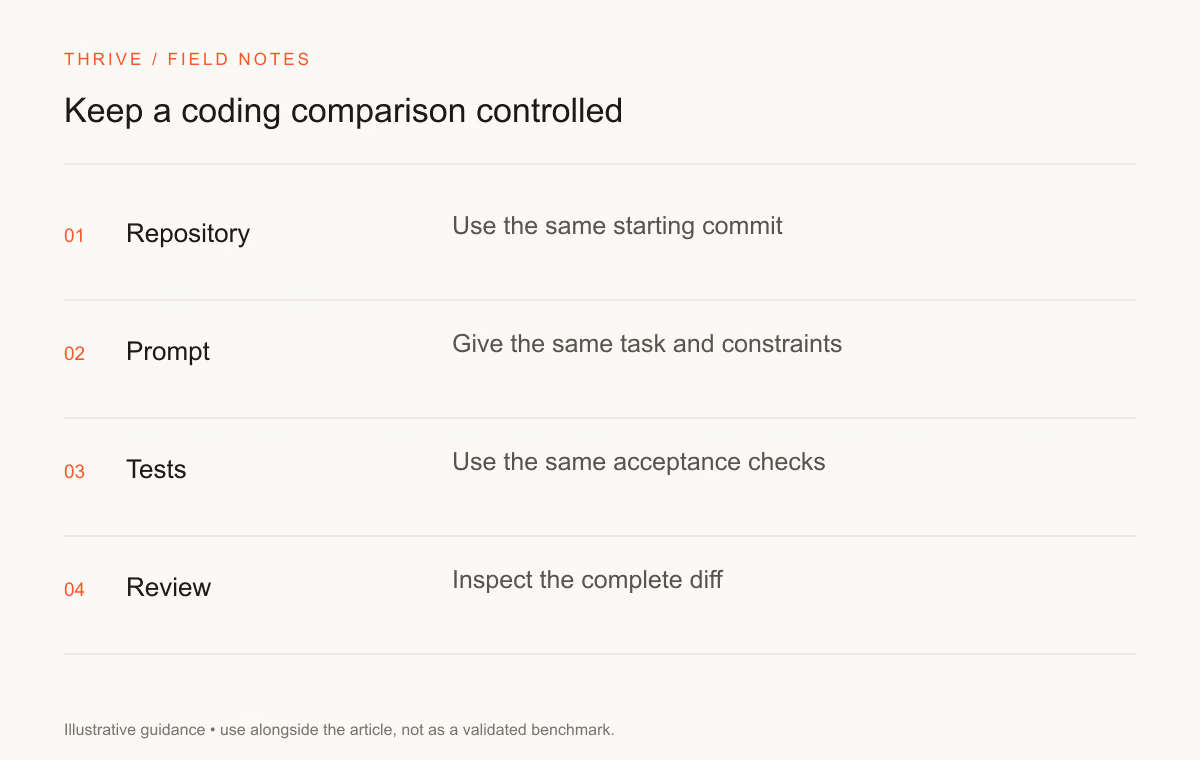
- Mismo repositorio → Mismas pruebas → Diff revisado.
- Conserva las fuentes y revisa el resultado antes de utilizarlo.
Compara GPT-6 Sol y Claude Opus 5.5 para programar con una versión fija del repositorio. Proporciona la misma tarea, herramientas y comprobaciones a cada modelo. Guarda el parche, el registro de comandos y las notas de revisión para explicar el resultado.
Este artículo ofrece un protocolo de prueba. Thrive no ha realizado este experimento entre modelos y no publica puntuaciones inventadas. Las especificaciones oficiales aportan información inicial; tus propias tareas aportan las pruebas para elegir.
Prepara una comparación equitativa
Elige un repositorio que tengas permiso para utilizar y retira los secretos del entorno de prueba. Registra el hash del commit y restaura el estado inicial antes de cada ejecución. Conserva una reproducción que falle para las tareas de corrección.
Proporciona las mismas instrucciones, archivos pertinentes y comandos permitidos. Establece un límite de tiempo o intentos y explica los criterios de revisión antes de empezar. Si un producto recibe herramientas de búsqueda adicionales, registra la diferencia y describe la prueba como una comparación de flujos.
Usa una rama de prueba. Mantén fuera las credenciales de producción y las acciones de despliegue. El asistente no debería necesitar enviar mensajes, publicar un paquete ni cambiar una base de datos activa para demostrar un parche local.
Usa cinco tipos de tareas
Tarea | Material inicial | Criterio de aceptación | Campo de resultado |
|---|---|---|---|
Depuración | Una reproducción que falla | Corrige la causa y añade una comprobación de regresión pertinente | Registrar tras ejecutar |
Refactorización | Código funcional e interfaces estables | Conserva el comportamiento y los contratos públicos | Registrar tras ejecutar |
Pruebas | Un requisito con casos límite conocidos | Prueba el comportamiento y revela un fallo significativo | Registrar tras ejecutar |
Razonamiento sobre el repositorio | Una pregunta acotada de arquitectura | Cita archivos relevantes y sigue la ruta real de llamadas | Registrar tras ejecutar |
Documentación | Una API o un comando actuales | Los ejemplos funcionan con la versión indicada | Registrar tras ejecutar |
«Registrar tras ejecutar» es una etiqueta de la hoja de trabajo, no un resultado de rendimiento. Puedes añadir filas relevantes para tu repositorio, como comprobaciones de autorización o revisión de migraciones.
Define requisitos concretos para la tarea
Escribe la entrada, el comportamiento esperado, las restricciones y el comando de comprobación. Una petición útil describe qué hizo el usuario, qué ocurrió y qué debería ocurrir. Incluye un mensaje de error o una reproducción cuando exista.
For a fictional application, a task might be: “When a signed-out visitor opens the private resume workspace, send them to sign-in and preserve the requested destination. Signed-in visitors should open the workspace. Keep public resume guidance accessible.” That defines two states and a boundary a reviewer can test.
Pide al asistente que explique qué archivos va a cambiar antes de ampliar el alcance. Una refactorización debe tener una razón relacionada con el comportamiento solicitado.
Usa el prompt de auditoría de TypeScript para un caso de revisión, y la skill de depuración para un caso basado en reproducción.
Revisa sin conocer el nombre del modelo
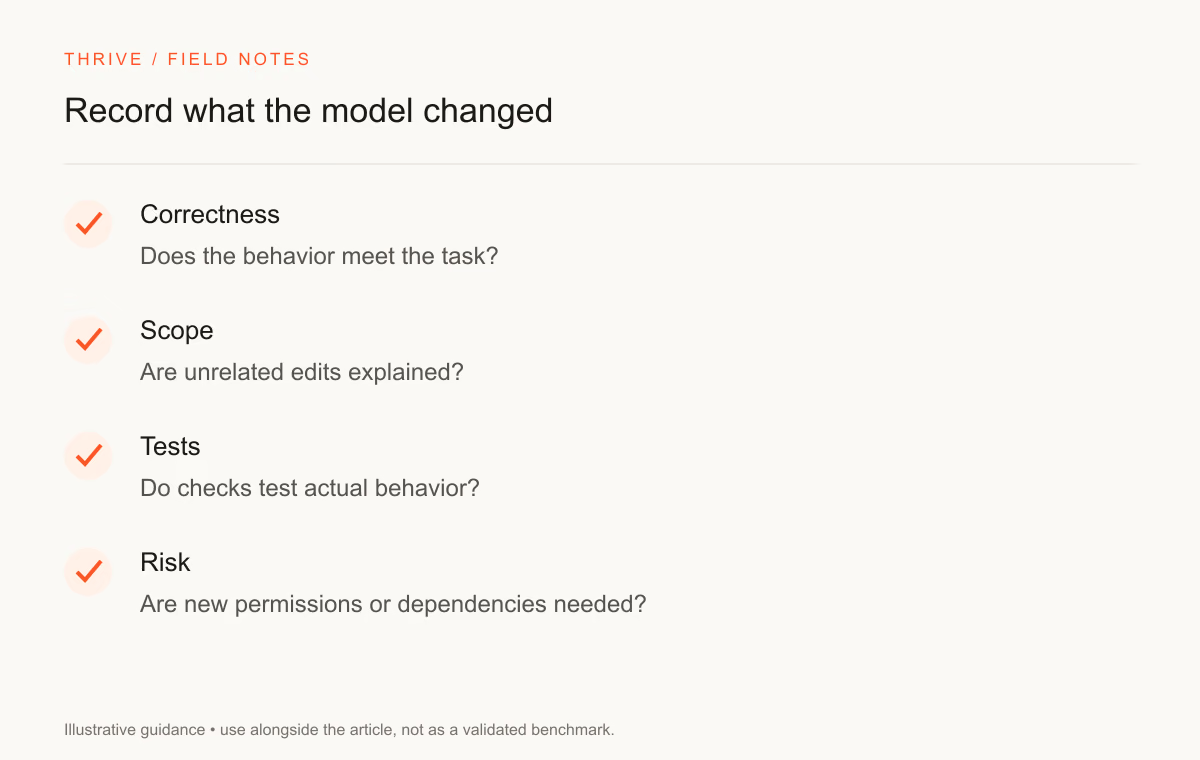
Entrega los parches al revisor con etiquetas neutras cuando sea posible. Pide que evalúe corrección, alcance, mantenimiento y verificación. Conserva un empate si ambos cumplen lo solicitado con un esfuerzo de revisión parecido.
Ejecuta las pruebas en un entorno limpio. Comprueba si el asistente debilitó alguna prueba, suprimió un error o cambió un ajuste para superarla. Registra el fallo y la corrección propuesta como pruebas separadas.
Revisa las dependencias y los cambios de permisos. Resolver un fallo visible ampliando el acceso puede crear un problema más grave. El revisor debe entender por qué cada cambio sensible forma parte de la solución.
Calcula el coste con el consumo real
Registra tokens de entrada y salida, reintentos, cargos de herramientas y tiempo del revisor. Usa la tarifa del proveedor aplicable a la petición. La comparación general de modelos explica las especificaciones base y un ejemplo aritmético acotado.
Compara el coste por tarea aceptada, además del precio por token. Un modelo puede utilizar más contexto o necesitar más intentos. Los tokenizadores y niveles de servicio pueden cambiar la factura de sesiones aparentemente similares.
Explica el resultado y sus límites
Indica los ID de modelos, ajustes, versión del repositorio, número de tareas, política de intentos, fecha y método del revisor. Explica los fallos y los éxitos. Presenta el resultado como pruebas de las tareas evaluadas, sin extenderlo a todo el trabajo de programación.
Conserva el registro original. Quien lea la comparación debe poder repetir las comprobaciones o entender por qué falló un caso. Repite los casos importantes tras cambios del modelo o de las herramientas del agente.
El flujo de evaluación de modelos y rúbrica de evaluación por pares puede organizar la revisión. Una versión sin datos identificativos puede servir para explicar tus decisiones de prueba en el portfolio.
Fuentes y notas de revisión
Thrive Editorial revisó estas fuentes el 28 de septiembre de 2026. Hemos diseñado la hoja de trabajo; no la hemos rellenado con resultados medidos de modelos.
Llévalo a la práctica
Tu siguiente paso
¿Tienes una pregunta o una corrección?
Contactar con Thrive