La versión breve
- Misma entrada → Revisión a ciegas → Coste medido.
- Conserva las fuentes y revisa el resultado antes de utilizarlo.
Claude Opus 5.5 y GPT-6 Sol pueden ayudar con programación y trabajo de conocimiento. Elige probando las tareas que quieras delegar con las mismas entradas y reglas de revisión. Las especificaciones indican límites de acceso y precios por token; no deciden qué modelo resolverá mejor tu proyecto.
Thrive revisó la documentación oficial el 28 de septiembre de 2026. Esta es una comparación de especificaciones y una guía de evaluación. No hemos realizado una prueba comparativa directa, por lo que las tablas no contienen puntuaciones de rendimiento inventadas.
Compara las especificaciones publicadas de API
Elemento | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
Proveedor | OpenAI | Anthropic |
ID del modelo en la API | gpt-6-sol | claude-opus-5-5 |
Ventana de contexto | 1.050.000 tokens | 1.000.000 de tokens |
Salida máxima | 128.000 tokens | 128.000 tokens |
Tarifa base de entrada por millón de tokens | 2 USD | 4 USD |
Tarifa base de salida por millón de tokens | 10 USD | 20 USD |
Fuentes: especificaciones de Sol de OpenAI, resumen de modelos de Anthropic, y precios de API de Anthropic. Estas tarifas base excluyen cargos por herramientas, caché, niveles de servicio, precios regionales y otras condiciones. OpenAI aplica tarifas superiores a las peticiones que superan su umbral documentado de entrada larga. Verifica las condiciones de facturación de tu carga antes de presupuestar.
Una tarifa de API es distinta de una suscripción de usuario. Un plan de ChatGPT o Claude no proporciona uso ilimitado de API a los precios de esta tabla. Comprueba el producto y la cuenta que utilizarás.
Mide el coste de una tarea terminada
Comparar precios por token sirve para una primera estimación. El coste real de la tarea incluye los reintentos y el tiempo de revisión.
Para una petición ilustrativa con 10.000 tokens de entrada sin caché y 2.000 de salida, el coste base de texto sería de 0,04 USD para Sol y 0,08 USD para Opus 5.5. El cálculo utiliza las tarifas de la tabla y supone que ningún proveedor añade otros cargos. Son ejemplos calculados, no facturas observadas ni una previsión de cuánto texto producirá cada modelo.
Guarda la respuesta de consumo del proveedor en cada prueba. Dos tokenizadores pueden contar el mismo documento de forma distinta. Un modelo que responde con más texto puede costar más de lo que sugiere un ejemplo con salida fija.
Prueba las tareas que vayas a encargar
Tipo de trabajo | Aporta a ambos modelos | Revisa en el resultado |
|---|---|---|
Cambio de código | La misma versión del repositorio y prueba que falla | Comportamiento correcto, cambios mínimos y comprobaciones superadas |
Resumen de investigación | Las mismas fuentes y pregunta | Afirmaciones respaldadas y citas exactas |
Edición de currículum | Los mismos hechos verificados y descripción del puesto | Hechos conservados y recortes útiles |
Revisión de documentos largos | El mismo documento y preguntas | Pruebas de secciones relevantes y carencias reconocidas |
Flujo de agentes | Las mismas herramientas y límites de permisos | Acciones seguras, recuperación y un registro de auditoría útil |
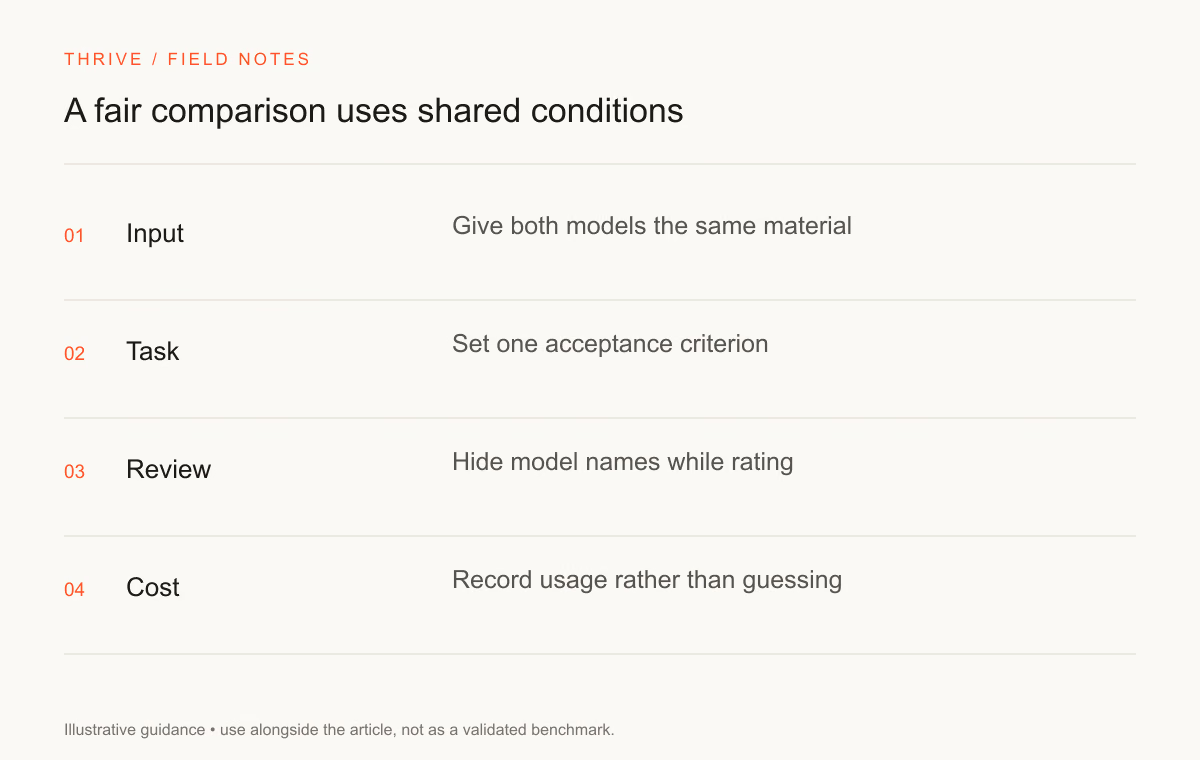
Define los criterios de aceptación antes de leer las respuestas. En una tarea de currículum, los hechos añadidos deben hacer fallar la revisión aunque el párrafo resulte convincente. En una tarea de código, una explicación segura no sustituye una prueba superada.
Usa el prompt de evaluación por pares para estructurar una comparación inicial. Oculta al revisor los nombres de los modelos cuando sea posible y conserva los empates. Registra los ajustes y el acceso a herramientas junto al resultado.
Distingue las funciones del producto del comportamiento del modelo
Una aplicación web puede añadir búsqueda, recuperación de archivos, conectores y exportación de documentos al modelo. Si comparas aplicaciones, incluye esas funciones. Si comparas modelos, mantén constantes las herramientas que los rodean.
En investigación, comprueba que el asistente haya abierto la fuente y que el pasaje citado respalde la afirmación. Para una candidatura, confirma tú mismo la empresa y la oferta vigente. Ningún modelo debe inventar cualificaciones ni enviar una candidatura sin tu revisión.
El guía de trabajo Claude vs ChatGPT aborda la elección entre productos. La comparación de programación ofrece un plan de prueba más acotado para repositorios.
Elige un modelo tras una prueba piloto
Elige tareas representativas, incluido un caso que esperes que falle. Compara la tasa de aceptación, el esfuerzo de revisión y el coste real. Repite los casos importantes tras cambios del modelo o las herramientas. Una prueba piloto aporta pruebas para tu contexto; no establece un ganador universal.
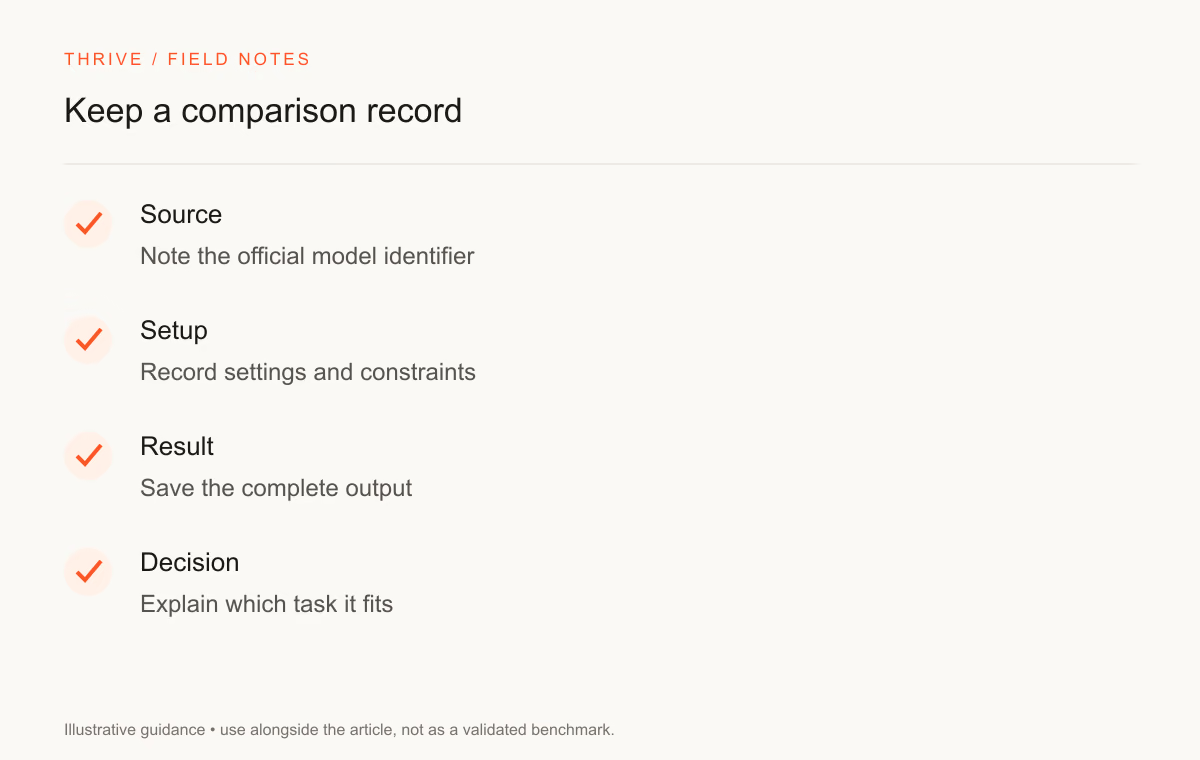
Guarda el prompt, las fuentes, el ID del modelo, la fecha y las notas del revisor. Puedes usar la skill de evaluación de modelos para organizar el registro y convertir una versión sin datos identificativos en una muestra de portfolio.
Fuentes y política de actualización
Thrive actualizará esta URL cuando cambie una especificación verificada. Comprueba de nuevo los precios y la disponibilidad antes de comprar o migrar.
Llévalo a la práctica
Tu siguiente paso
¿Tienes una pregunta o una corrección?
Contactar con Thrive