La versión breve
- Define la tarea → Evalúa las rutas → Registra los fallos.
- Conserva las fuentes y revisa el resultado antes de utilizarlo.
GPT-6 Sol, Luna y Astra ofrecen distintas opciones de complejidad y coste. OpenAI presenta Astra para el trabajo más exigente, Sol para programación y flujos con agentes y Luna para tareas acotadas de gran volumen. Empieza con una tarea que puedas evaluar y decide qué modelo cumple tus criterios a un coste aceptable.
Estas especificaciones reflejan la documentación oficial de OpenAI revisada el 28 de septiembre de 2026. La guía no presenta una prueba comparativa de Thrive ni promete un rendimiento superior en tus tareas.
Compara las especificaciones publicadas
Elemento | GPT-6 Luna | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
ID del modelo en la API | gpt-6-luna | gpt-6-sol | gpt-6-astra |
Entrada base por millón de tokens | 0,10 USD | 2 USD | 10 USD |
Salida base por millón de tokens | 0,50 USD | 10 USD | 50 USD |
Ventana de contexto | 1.050.000 tokens | 1.050.000 tokens | 1.050.000 tokens |
Salida máxima | 128.000 tokens | 128.000 tokens | 128.000 tokens |
Fuentes: páginas oficiales de Luna, Sol, y Astra. La tabla usa tarifas base de texto. Verifica la caché, las condiciones de entrada larga, los niveles de servicio, el procesamiento regional y los cargos por herramientas antes de calcular una factura.
Una ventana de contexto amplia establece un límite de capacidad. No demuestra que el modelo utilice bien todo el material. Prueba si encuentra y aplica las pruebas relevantes para tu pregunta.
Asigna el modelo según los criterios de aceptación
Tarea de ejemplo | Candidato para probar primero | Pruebas necesarias para conservarlo |
|---|---|---|
Extraer campos de un documento corto | Luna | Campos válidos, valores respaldados y tratamiento correcto de datos ausentes |
Implementar un cambio acotado de repositorio | Sol | Pruebas superadas y diff revisable |
Investigar varias restricciones que interactúan | Astra | Explicación respaldada y comprobaciones de los casos importantes |
Reescribir una viñeta del currículum | Una prueba acotada entre los modelos disponibles | Hechos conservados y redacción útil |
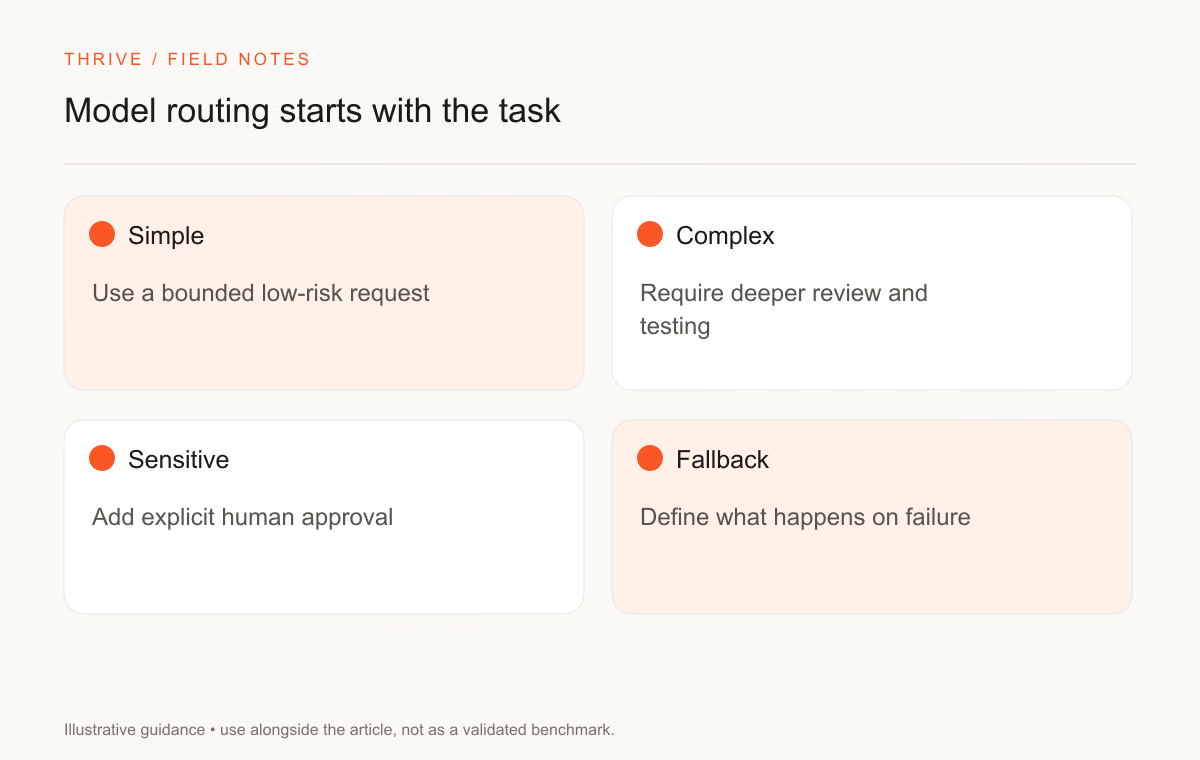
Estas son rutas de prueba propuestas, no clasificaciones medidas. Tu evaluación puede llevar a otra elección. Una extracción sensible puede necesitar más revisión que una tarea de escritura extensa de bajo riesgo.
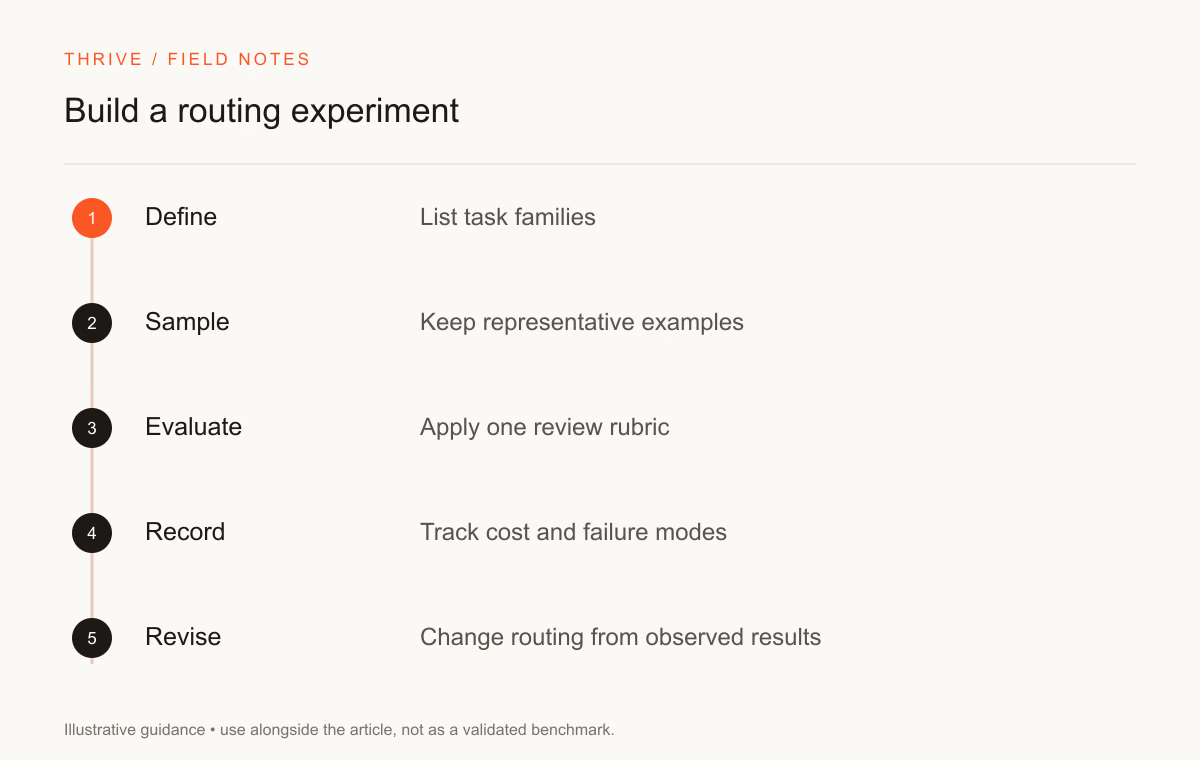
Conserva ejemplos con resultados aceptables conocidos. Incluye campos ausentes, instrucciones contradictorias y entradas fuera del rango normal. Considera aceptable abstenerse o escalar la tarea cuando las pruebas no respalden una respuesta.
Calcula un coste base de ejemplo
Con 10.000 tokens de entrada sin caché y 2.000 de salida, las tarifas base de la tabla dan 0,002 USD para Luna, 0,04 USD para Sol y 0,20 USD para Astra. Son ejemplos aritméticos con recuentos fijos, no consumo observado ni previsiones de la longitud de las respuestas.
Añade los cargos aplicables a la petición. Cuenta los reintentos y los fallos. Compara el coste total por tarea aceptada tras la revisión, sin suponer que la tarifa más baja por token implica el menor coste de trabajo terminado.
Para una suscripción de usuario o agente de programación, utiliza las condiciones del plan. Los precios de API y las cuotas de suscripción describen formas de facturación distintas.
Define una regla de escalado antes de producción
Define las condiciones que requieren un modelo más capaz o revisión humana. Puedes escalar un documento con valores contradictorios, un cambio que falle una prueba de regresión o una salida sin las citas obligatorias.
Conserva la entrada original y el motivo del fallo junto a la tarea escalada. El segundo modelo necesita las pruebas que causaron el problema. Pedir una respuesta más segura puede ocultar la incertidumbre sin resolverla.
Usa el flujo de evaluación de modelos para definir el éxito, y el prompt de auditoría de errores de salida para clasificar los fallos. Prueba de nuevo el modelo pequeño con un conjunto reservado antes de ampliar su trabajo.
Mantén la evaluación estable entre actualizaciones
Registra el ID del modelo, fecha, ajustes, entrada, herramientas, salida y decisión del revisor. Repite casos representativos cuando cambie el proveedor o la aplicación. Un resultado en una configuración no demuestra rendimiento en otra.
Para programación, lee la guía de selección de IA para programar. Para decidir entre proveedores, usa la comparación Opus 5.5 vs Sol.
Puedes convertir un experimento de asignación de modelos sin datos identificativos en un proyecto de portfolio. Explica los criterios de aceptación, los fallos observados y las decisiones de revisión, y describe tu aportación con la herramienta de currículum.
Fuentes y notas de actualización
Thrive Editorial revisó estas fuentes el 28 de septiembre de 2026. Comprueba los precios y el acceso de tu cuenta antes de comprometer una carga de trabajo.
Llévalo a la práctica
Tu siguiente paso
¿Tienes una pregunta o una corrección?
Contactar con Thrive