La versión breve
- Tarea pequeña → Diff probado → Revisión humana.
- Conserva las fuentes y revisa el resultado antes de utilizarlo.
Elige la mejor IA para programar probando un cambio en el tipo de repositorio que mantienes. Proporciona al asistente un requisito concreto, una versión fija del código y un comando de pruebas. Revisa el diff y ejecuta las comprobaciones antes de decidir si la herramienta te ahorra trabajo.
Un modelo, un asistente de IDE y un agente de programación tienen distintos niveles de acceso. Un agente puede editar archivos y ejecutar comandos; una sesión de chat puede producir código para que lo copies. Compara el proceso completo que quieras utilizar.
Empieza por el modelo y las herramientas que lo acompañan
OpenAI presenta GPT-6 Sol para programación y trabajo con agentes; Astra y Luna cubren otras necesidades de coste y capacidad. Anthropic presenta Opus 5.5 para programación con agentes y trabajo de conocimiento. Estas descripciones permiten elegir candidatos, pero no determinan cuál es mejor para tu repositorio.
Candidato | Posicionamiento del proveedor | Prueba propuesta |
|---|---|---|
GPT-6 Sol | Programación y flujos con agentes | Una prueba que falla y una implementación acotada |
GPT-6 Astra | Razonamiento complejo y programación | Un cambio con varias restricciones que interactúan |
GPT-6 Luna | Trabajo acotado de gran volumen | Una transformación limitada con comprobaciones automáticas |
Claude Opus 5.5 | Programación con agentes y trabajo de conocimiento | Una tarea de repositorio con hitos revisables |
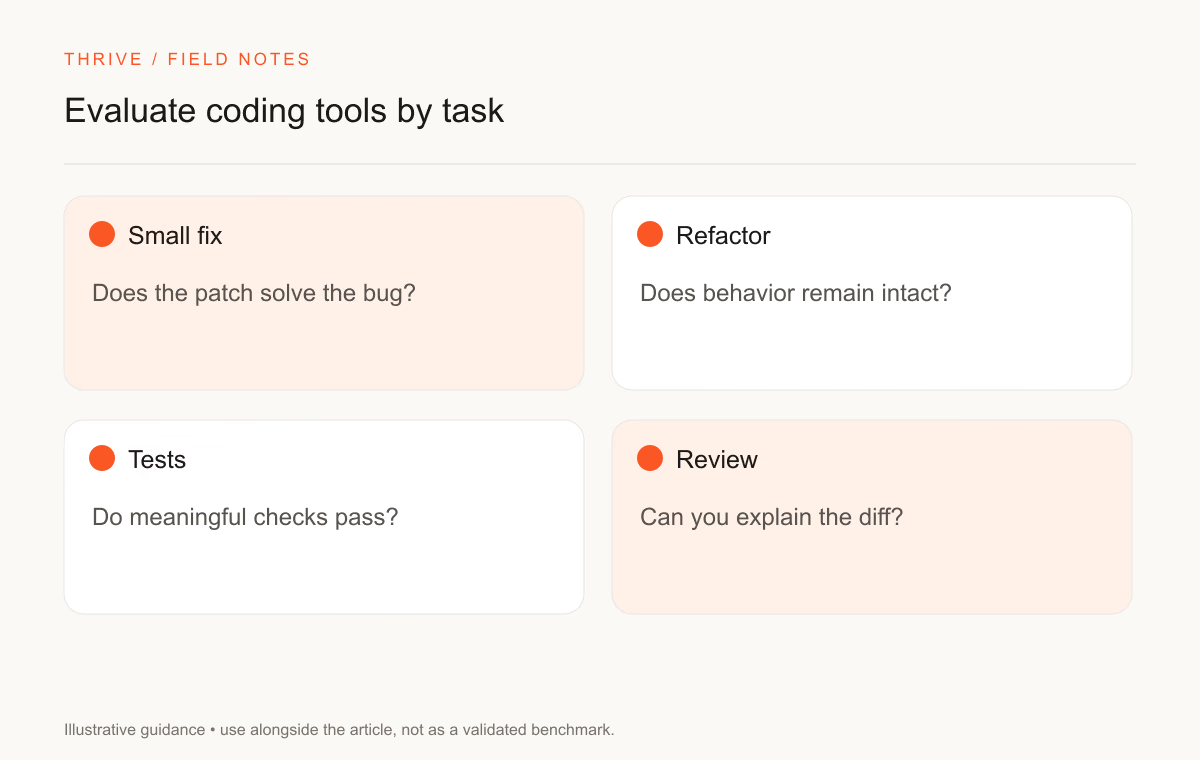
Fuentes: catálogo de modelos de OpenAI y resumen de modelos de Anthropic. Revisa el acceso actual, los límites de uso y los precios del producto elegido. Esta guía no presenta resultados de pruebas comparativas realizadas.
Prepara pruebas específicas del repositorio
Elige ejemplos de las tareas que repites. Incluye un fallo, una función pequeña y una revisión. Añade al menos un caso en el que un atajo tentador incumpla una restricción importante.
Usa una rama limpia y conserva el commit inicial. Proporciona las mismas instrucciones y herramientas permitidas a cada candidato. Registra el modelo, el nivel de esfuerzo, el contexto y los comandos que ejecuta el asistente.
Tarea | Comprobación de aceptación | Fallo que registrar |
|---|---|---|
Corrección de errores | La reproducción falla antes del cambio y pasa después | El asistente oculta el fallo |
Función | El comportamiento solicitado funciona y el anterior se conserva | Cambios de API no solicitados |
Refactorización | Las pruebas y las interfaces se mantienen estables | Ediciones más amplias sin motivo |
Revisión de código | Los hallazgos incluyen un problema reproducible | Advertencias sin fundamento sobre fallos hipotéticos |
Documentación | Los ejemplos coinciden con la API real | Opciones o firmas inventadas |
Un flujo de depuración puede estructurar el primer caso. Para TypeScript, usa el prompt de auditoría de arquitectura para delimitar la revisión.
Haz explícitos los límites de permisos
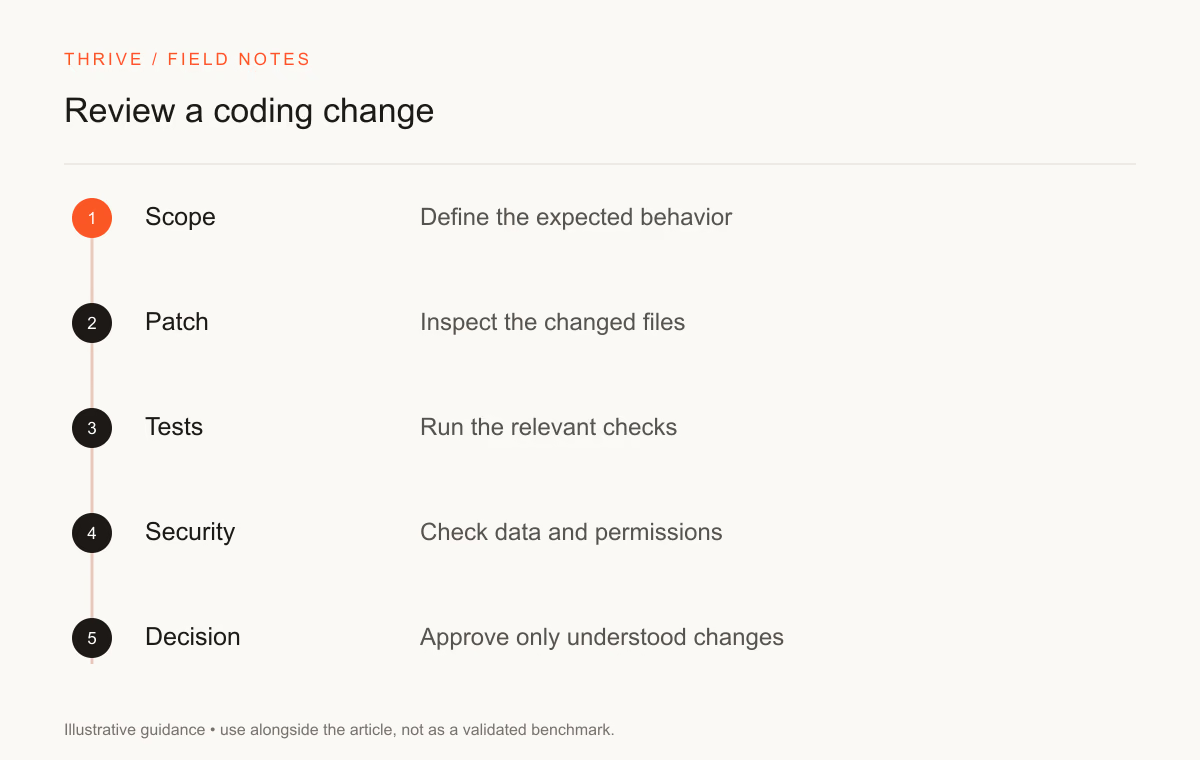
Limita al asistente al repositorio y los comandos necesarios. Mantén las credenciales fuera de los prompts y los registros. Revisa las instalaciones de paquetes, los cambios de base de datos y las acciones externas propuestas antes de permitirlas en un entorno de prueba.
Lee el diff antes de ejecutar código generado en sistemas sensibles. Superar una prueba unitaria no demuestra que un comando de despliegue o una migración de base de datos sean seguros. Separa la implementación local de la aprobación del lanzamiento.
Si el repositorio contiene datos de usuarios, incluye una prueba de propiedad o autorización. Una función puede superar el caso normal y aun así permitir que una cuenta lea los registros de otra.
Mide el esfuerzo de revisión y el coste de uso
Registra el tiempo dedicado a corregir el resultado, además del tiempo hasta la primera respuesta. Un parche rápido que necesite muchas reparaciones puede requerir más atención que uno más lento y utilizable. Anota cuándo tuviste que explicar de nuevo el requisito.
El coste de la API depende de los tokens, las condiciones del servicio y las herramientas. Las suscripciones de IDE o agentes pueden imponer sus propios límites. Calcula el coste por tarea aceptada con tu consumo real y los precios vigentes del proveedor.
Conserva los intentos fallidos en el registro. Eliminarlos después de la prueba puede hacer que la herramienta parezca más fiable. Mantén los empates cuando tus reglas no permitan distinguir los resultados.
Elige una opción predeterminada y una ruta de escalado
Tras una prueba piloto, elige una opción predeterminada para un tipo de trabajo definido. Puedes usar un candidato para transformaciones cortas y otro para investigar un repositorio difícil. Repite la evaluación cuando cambien los modelos o el código.
El protocolo de programación Sol vs Opus ofrece una hoja de comparación detallada. La guía de la familia GPT-6 explica cómo asignar tareas a los modelos de OpenAI.
Convierte una evaluación sin datos identificativos en una entrada de portfolio: indica la tarea, el estado inicial, las comprobaciones y el resultado. Utiliza la skill de revisión de código y herramienta de currículum para documentar la aportación sin atribuirte una prueba comparativa que no hayas realizado.
Fuentes y notas de revisión
Thrive Editorial revisó estas fuentes el 28 de septiembre de 2026. Las comprobaciones de aceptación son una propuesta original, no pruebas de que Thrive haya evaluado los modelos mencionados.
Llévalo a la práctica
Tu siguiente paso
¿Tienes una pregunta o una corrección?
Contactar con Thrive