Versão breve
- Defina a tarefa → Avalie as opções → Registe as falhas.
- Guarde as fontes e reveja o resultado antes de o utilizar.
GPT-6 Sol, Luna e Astra oferecem opções diferentes de complexidade e custo. A OpenAI apresenta o Astra para o trabalho mais exigente, o Sol para programação e fluxos com agentes, e o Luna para tarefas delimitadas de grande volume. Comece por uma tarefa que consiga avaliar e escolha o modelo que cumpre os seus critérios a um custo aceitável.
As especificações abaixo refletem a documentação oficial da OpenAI consultada em 28 de setembro de 2026. Este guia não apresenta um benchmark da Thrive nem promete melhores resultados de um modelo no seu trabalho concreto.
Compare as especificações publicadas
Item | GPT-6 Luna | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
ID do modelo na API | gpt-6-luna | gpt-6-sol | gpt-6-astra |
Preço base de entrada por milhão de tokens | 0,10 USD | 2 USD | 10 USD |
Preço base de saída por milhão de tokens | 0,50 USD | 10 USD | 50 USD |
Janela de contexto | 1 050 000 tokens | 1 050 000 tokens | 1 050 000 tokens |
Saída máxima | 128 000 tokens | 128 000 tokens | 128 000 tokens |
Fontes: páginas oficiais de Luna, Sol e Astra. A tabela utiliza preços base de texto. Verifique a cache, as condições de entradas longas, os níveis de serviço, o processamento regional e os custos de ferramentas antes de calcular uma fatura.
Uma janela de contexto grande define um limite de capacidade. Não comprova que o modelo utilizará bem todos os documentos fornecidos. Teste se encontra e aplica as provas relevantes para a pergunta.
Escolha o modelo segundo os critérios de aceitação da tarefa
Exemplo de tarefa | Candidato a experimentar primeiro | Provas necessárias para o manter |
|---|---|---|
Extrair campos de um documento curto | Luna | Campos válidos, valores fundamentados e tratamento correto de dados em falta |
Implementar uma alteração delimitada num repositório | Sol | Testes aprovados e alterações que possam ser revistas |
Investigar várias restrições interdependentes | Astra | Explicação fundamentada e verificações dos casos importantes |
Reescrever um ponto do currículo | Um teste delimitado entre os modelos disponíveis | Factos preservados e redação útil |
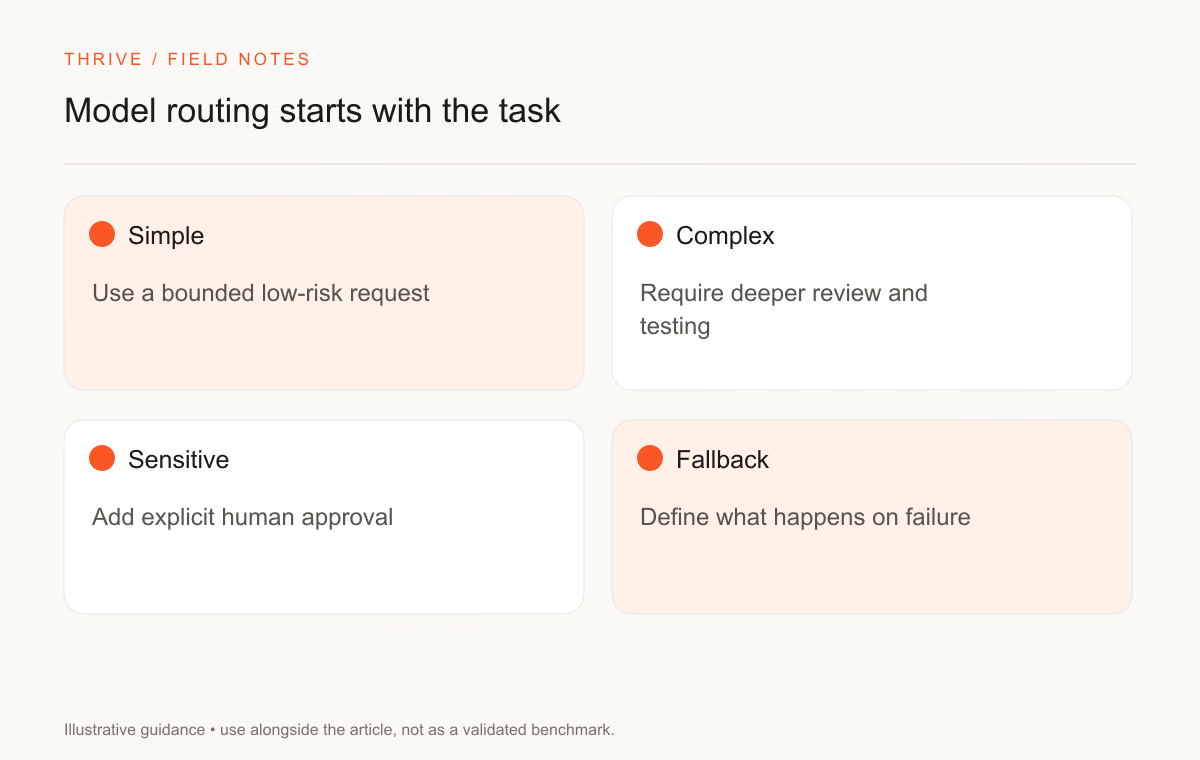
Estes são percursos de teste propostos, não classificações medidas. A sua avaliação pode levar a outra escolha. Uma extração de dados sensíveis pode exigir mais revisão do que uma tarefa grande de escrita de baixo risco.
Guarde exemplos com resultados aceitáveis conhecidos. Inclua campos em falta, instruções contraditórias e entradas fora do intervalo habitual. Considere aceitável reconhecer a ausência de resposta ou encaminhar a tarefa quando as provas não permitirem responder.
Calcule um custo base ilustrativo
Para 10 000 tokens de entrada sem cache e 2 000 de saída, os preços base da tabela resultam em 0,002 USD para Luna, 0,04 USD para Sol e 0,20 USD para Astra. São exemplos aritméticos com contagens fixas, não utilização observada nem previsões do comprimento das respostas.
Acrescente os custos aplicáveis ao pedido. Conte as novas tentativas e as tentativas falhadas. Compare o custo total por tarefa aceite após revisão em vez de assumir que o preço por token mais baixo produz o trabalho concluído mais barato.
Numa subscrição para consumidores ou agentes de programação, utilize as condições do plano do produto. Os preços da API e os limites das subscrições descrevem formas de faturação diferentes.
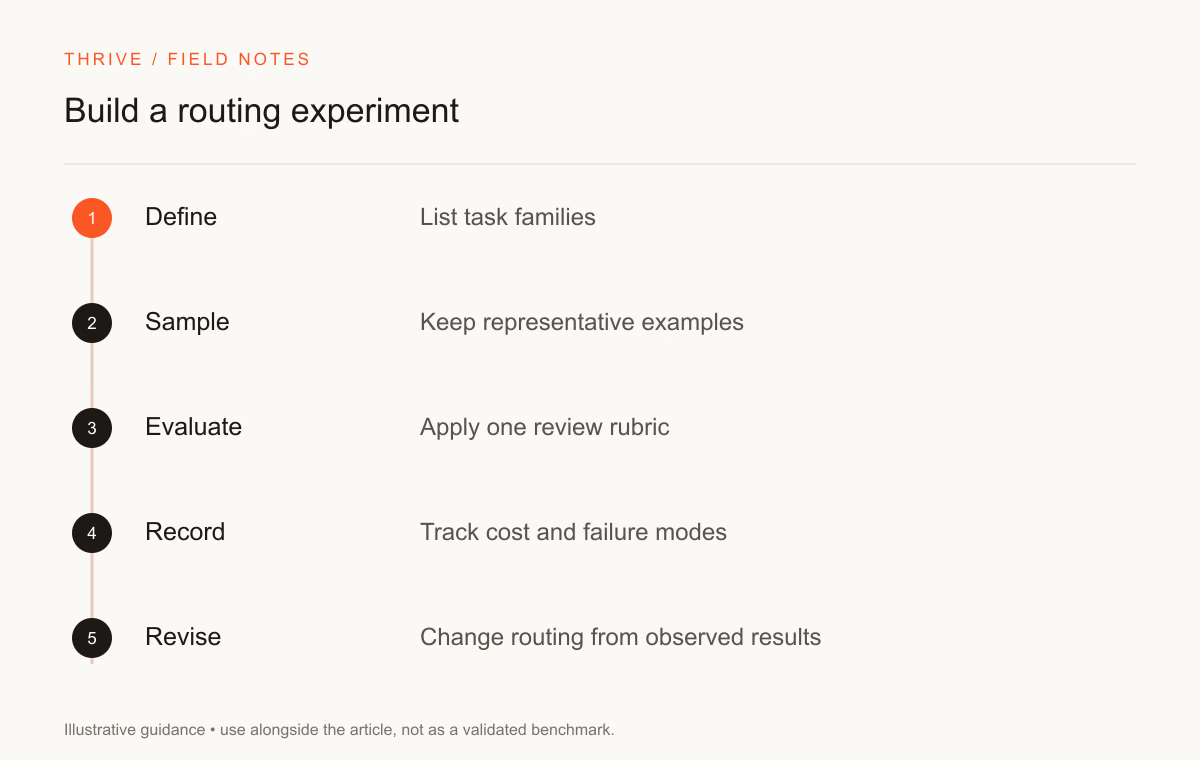
Defina quando recorrer a outro modelo antes de entrar em produção
Defina as condições que exigem um modelo mais capaz ou revisão humana. Pode encaminhar um documento com valores contraditórios nas fontes, uma alteração de código que falha um teste de regressão ou uma resposta sem citações obrigatórias.
Guarde a entrada original e o motivo da falha juntamente com a tarefa encaminhada. O segundo modelo precisa das provas que causaram o problema. Pedir uma resposta mais confiante pode esconder a incerteza sem a resolver.
Utilize o fluxo de avaliação de modelos para definir o sucesso e o prompt de auditoria de erros de saída para classificar falhas. Volte a testar o modelo mais pequeno num conjunto separado antes de ampliar o trabalho que lhe atribui.
Mantenha a avaliação consistente entre atualizações
Registe o ID do modelo, a data, as definições, as entradas, as ferramentas, os resultados e a decisão do revisor. Volte a executar casos representativos quando o fornecedor mudar o comportamento ou alterar a aplicação envolvente. Um resultado numa configuração não comprova o desempenho noutra.
Para programação, leia o guia de escolha de IA para programação. Para decidir entre fornecedores, utilize a comparação Opus 5.5 vs Sol.
Pode transformar uma experiência de distribuição de tarefas sem dados identificáveis num projeto de portefólio. Explique os critérios de aceitação, as falhas observadas e as decisões de revisão e descreva a sua contribuição no criador de currículos.
Fontes e notas de atualização
A equipa editorial da Thrive consultou estas fontes em 28 de setembro de 2026. Volte a verificar preços e acesso à conta antes de assumir um volume de trabalho.
Ponha em prática
O seu próximo passo
Tem uma pergunta ou uma correção?
Contactar a Thrive