Versão breve
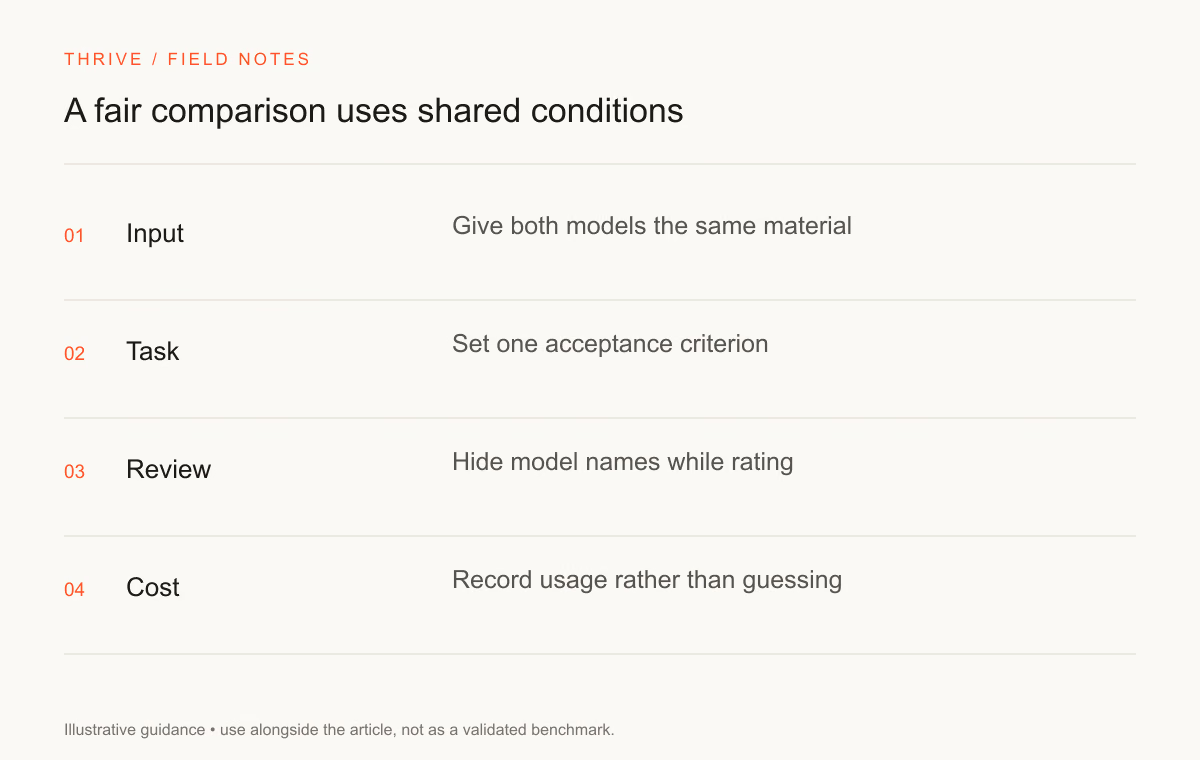
- Mesma entrada → Revisão sem identificar o modelo → Custo medido.
- Guarde as fontes e reveja o resultado antes de o utilizar.
O Claude Opus 5.5 e o GPT-6 Sol podem apoiar a programação e o trabalho de conhecimento. Compare-os nas tarefas que pretende delegar, com as mesmas entradas e regras de revisão. As especificações indicam limites de acesso e preços por token; não determinam qual modelo terá melhores resultados no seu projeto.
A Thrive consultou a documentação oficial em 28 de setembro de 2026. Este é um guia de especificações e avaliação. Não realizámos um benchmark direto entre os modelos, pelo que as tabelas não incluem pontuações de desempenho inventadas.
Compare as especificações publicadas da API
Item | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
Fornecedor | OpenAI | Anthropic |
ID do modelo na API | gpt-6-sol | claude-opus-5-5 |
Janela de contexto | 1 050 000 tokens | 1 000 000 de tokens |
Saída máxima | 128 000 tokens | 128 000 tokens |
Preço base de entrada por milhão de tokens | 2 USD | 4 USD |
Preço base de saída por milhão de tokens | 10 USD | 20 USD |
Fontes: especificação do Sol da OpenAI, apresentação dos modelos da Anthropic e preços da API da Anthropic. Estes preços base excluem custos de ferramentas, cache, níveis de serviço, preços regionais e outras condições. A OpenAI aplica preços superiores a pedidos acima do limite documentado de entrada longa. Verifique as condições de faturação do seu trabalho antes de definir um orçamento.
O preço da API é distinto de uma subscrição para consumidores. Um plano ChatGPT ou Claude não oferece utilização ilimitada da API aos preços da tabela. Verifique o produto e a conta que utilizará.
Meça o custo de uma tarefa concluída
A comparação do preço por token ajuda numa estimativa inicial. O custo real da tarefa também inclui novas tentativas e o tempo de revisão do resultado.
Num pedido ilustrativo com 10 000 tokens de entrada sem cache e 2 000 tokens de saída, os custos base de texto seriam 0,04 USD para Sol e 0,08 USD para Opus 5.5. O cálculo utiliza os preços da tabela e pressupõe que nenhum fornecedor aplica custos adicionais. São exemplos calculados, não faturas observadas nem previsões da quantidade de texto produzida por cada modelo.
Guarde a resposta de utilização do fornecedor para cada teste. Dois tokenizadores podem contar o mesmo documento de forma diferente. Um modelo que produz uma resposta mais longa pode custar mais do que o exemplo com saída fixa sugere.
Teste o trabalho que pretende delegar
Tipo de trabalho | Forneça aos dois modelos | Reveja o resultado quanto a |
|---|---|---|
Alteração de código | A mesma versão do repositório e teste que falha | Comportamento correto, alterações mínimas e verificações aprovadas |
Resumo de investigação | Os mesmos documentos de referência e pergunta | Afirmações fundamentadas e citações corretas |
Edição de currículo | Os mesmos factos verificados e descrição da função | Preservação dos factos e cortes úteis |
Revisão de documento longo | O mesmo documento e perguntas | Provas de secções relevantes e reconhecimento das lacunas |
Fluxo de trabalho de agente | As mesmas ferramentas e limites de permissões | Ações seguras, recuperação e um registo de auditoria útil |
Defina os critérios de aceitação antes de ler as respostas. Numa tarefa de currículo, acrescentar factos deve reprovar a revisão, mesmo que o parágrafo soe convincente. Numa tarefa de código, uma explicação confiante não substitui um teste aprovado.
Utilize o prompt de avaliação por pares para estruturar uma comparação inicial. Sempre que possível, esconda do revisor a identificação dos modelos e mantenha empates. Registe as definições e o acesso às ferramentas juntamente com o resultado.
Distinga funcionalidades do produto e comportamento do modelo
Uma aplicação web pode fornecer pesquisa, recuperação de ficheiros, conectores e exportação de documentos à volta de um modelo. Se comparar aplicações, essas funcionalidades pertencem à avaliação. Se comparar modelos, mantenha constantes as ferramentas que os rodeiam.
Na investigação, verifique se o assistente consultou a fonte e se a passagem citada sustenta a afirmação. Numa candidatura a emprego, confirme pessoalmente o empregador e a oferta atual. Nenhum modelo deve inventar qualificações ou enviar uma candidatura sem a sua revisão.
O guia de trabalho Claude vs ChatGPT aborda escolhas ao nível do produto. A comparação de programação oferece um plano de teste mais delimitado para repositórios.
Escolha um modelo depois de um pequeno teste-piloto
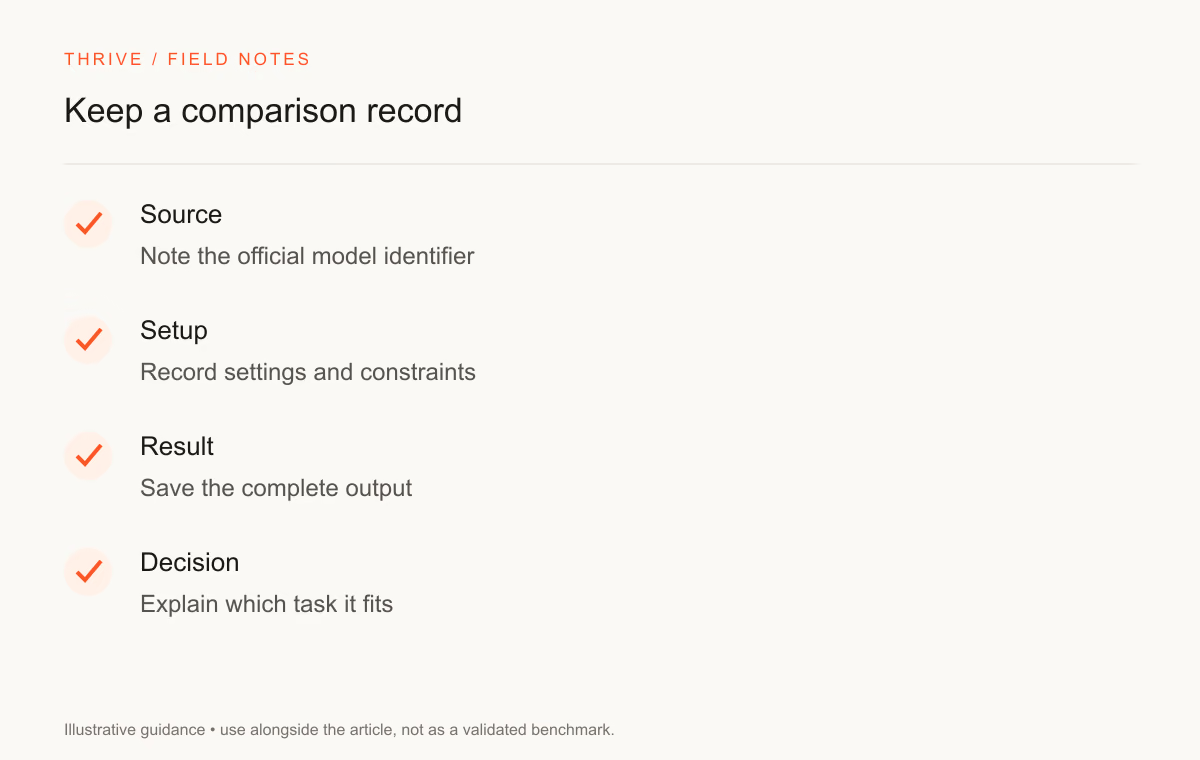
Escolha tarefas representativas, incluindo um caso em que espera uma falha. Compare a taxa de aceitação, o esforço de revisão e o custo real de utilização. Volte a executar os casos importantes após uma atualização do modelo ou da ferramenta. Um pequeno teste-piloto fornece provas locais; não estabelece um vencedor universal.
Guarde o prompt, os documentos de referência, o ID do modelo, a data e as notas do revisor. Pode utilizar a skill de avaliação de modelos para organizar esse registo e transformar uma versão sem dados identificáveis em provas para o portefólio.
Fontes e política de atualização
A Thrive atualizará este URL quando uma especificação verificada mudar. Os preços e a disponibilidade exigem uma nova consulta antes de comprar ou migrar.
Ponha em prática
O seu próximo passo
Tem uma pergunta ou uma correção?
Contactar a Thrive