La version courte
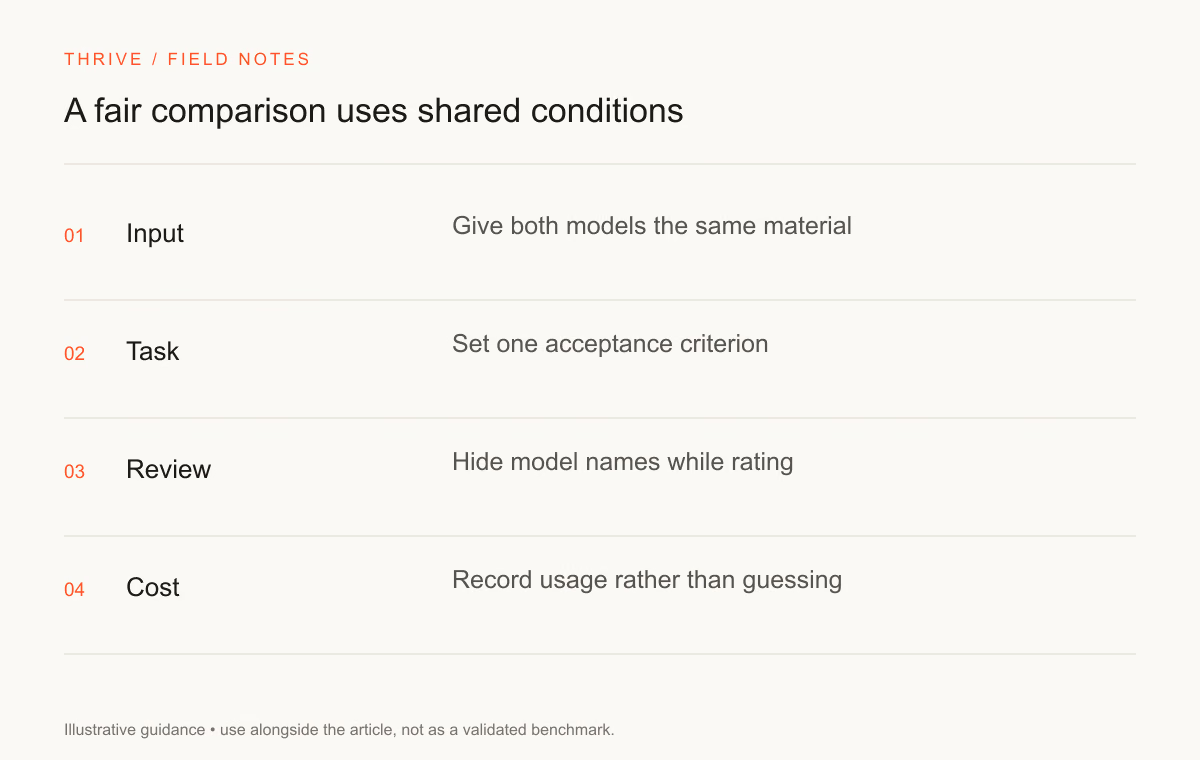
- Même entrée → Revue en aveugle → Coût mesuré.
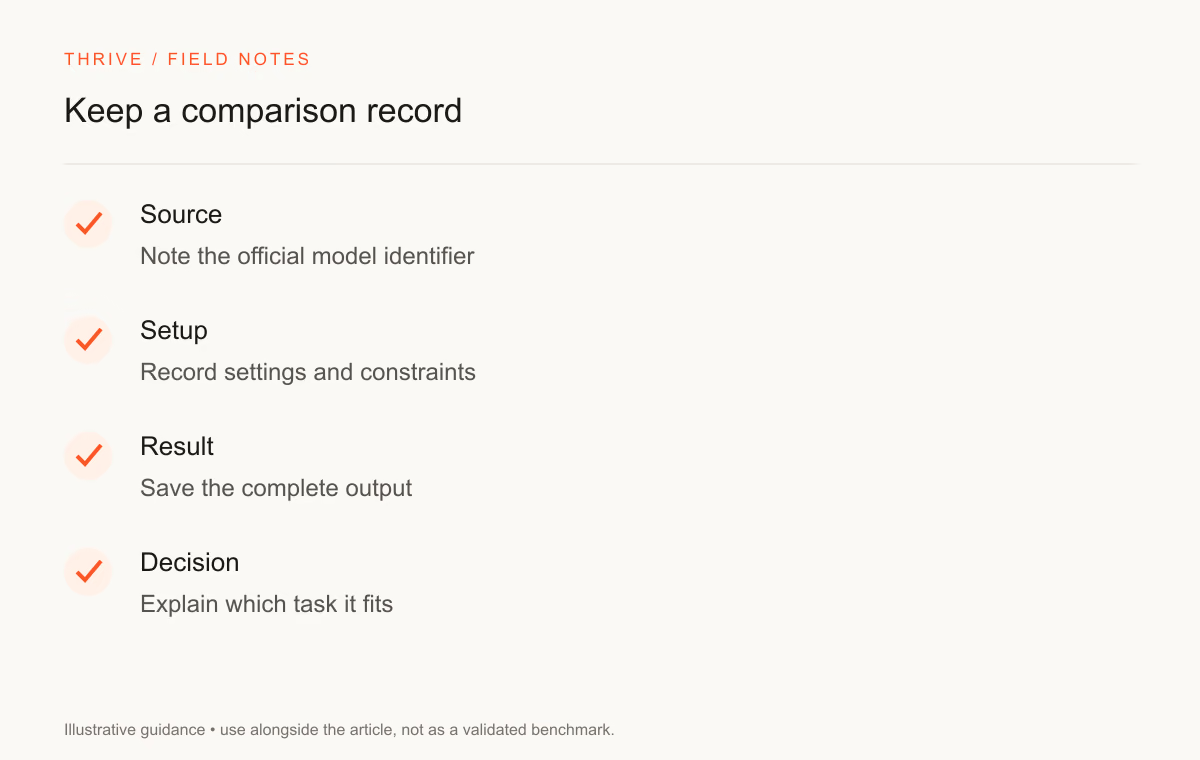
- Conserver les preuves et vérifier le résultat avant de l’utiliser.
Claude Opus 5.5 et GPT-6 Sol peuvent être envisagés pour le code et le travail de connaissance. Comparez les tâches que vous voulez leur confier avec les mêmes données et critères. Une fiche technique précise les limites et les prix ; elle ne prouve pas quel modèle convient le mieux à votre projet.
Comparer les tarifs dans leur contexte
La documentation utilisée par le guide source indique gpt-6-sol chez OpenAI et claude-opus-5-5 chez Anthropic. Le contexte est respectivement de 1 050 000 et de 1 000 000 tokens, avec une sortie maximale de 128 000 tokens pour les deux modèles. Les tarifs de base par million de tokens sont de 2 dollars en entrée et 10 en sortie pour Sol, contre 4 et 20 pour Opus 5.5.
Ces tarifs excluent les outils, le cache, les niveaux de service et d’autres conditions. OpenAI applique des tarifs plus élevés au-delà du seuil d’entrée longue documenté. Une formule ChatGPT ou Claude grand public ne donne pas un usage API illimité à ces prix.
Avec 10 000 tokens d’entrée non mis en cache et 2 000 en sortie, le calcul de base donne 0,04 dollar pour Sol et 0,08 dollar pour Opus. Il s’agit d’un exemple arithmétique, pas d’une facture observée. Les tokenizers, la longueur produite et les nouvelles tentatives changent l’usage réel.
Tester les résultats attendus
Pour le code, utilisez le même dépôt et le même test défaillant. Pour une synthèse, utilisez les mêmes sources. Pour un CV, fournissez les mêmes faits vérifiés. Pour un document long, demandez des citations précises et la reconnaissance des informations absentes. Pour un agent, imposez la même limite de permissions.
Fixez les règles avant de lire les réponses. Ajouter une compétence inventée au CV doit faire échouer la revue, même si le texte est convaincant. Un discours assuré ne remplace pas un test réussi. Masquez les noms des modèles au relecteur si possible et gardez les égalités.
Distinguer l’application du modèle
Une application web peut fournir recherche, fichiers, connecteurs et exports autour du modèle. Si vous comparez les applications, ces fonctions font partie du test. Si vous comparez les modèles, maintenez les outils constants.
Commencez par un petit pilote incluant un cas difficile. Conservez les prompts, les sources, les identifiants de modèles, les réglages, les dates et les notes de revue. Comparez le taux de tâches acceptées, l’effort de correction et le coût réel. Thrive n’a effectué aucun face-à-face et ne publie pas de scores de performance inventés.
Exemples et visuels d’origine
Sources et ressources
Mise en pratique
Votre prochaine étape
Vous avez une question ou une correction?
Contacter Thrive