La version courte
- Confirmer l’accès autorisé → Conserver le contexte → Limiter les conclusions.
- Conserver les preuves et vérifier le résultat avant de l’utiliser.
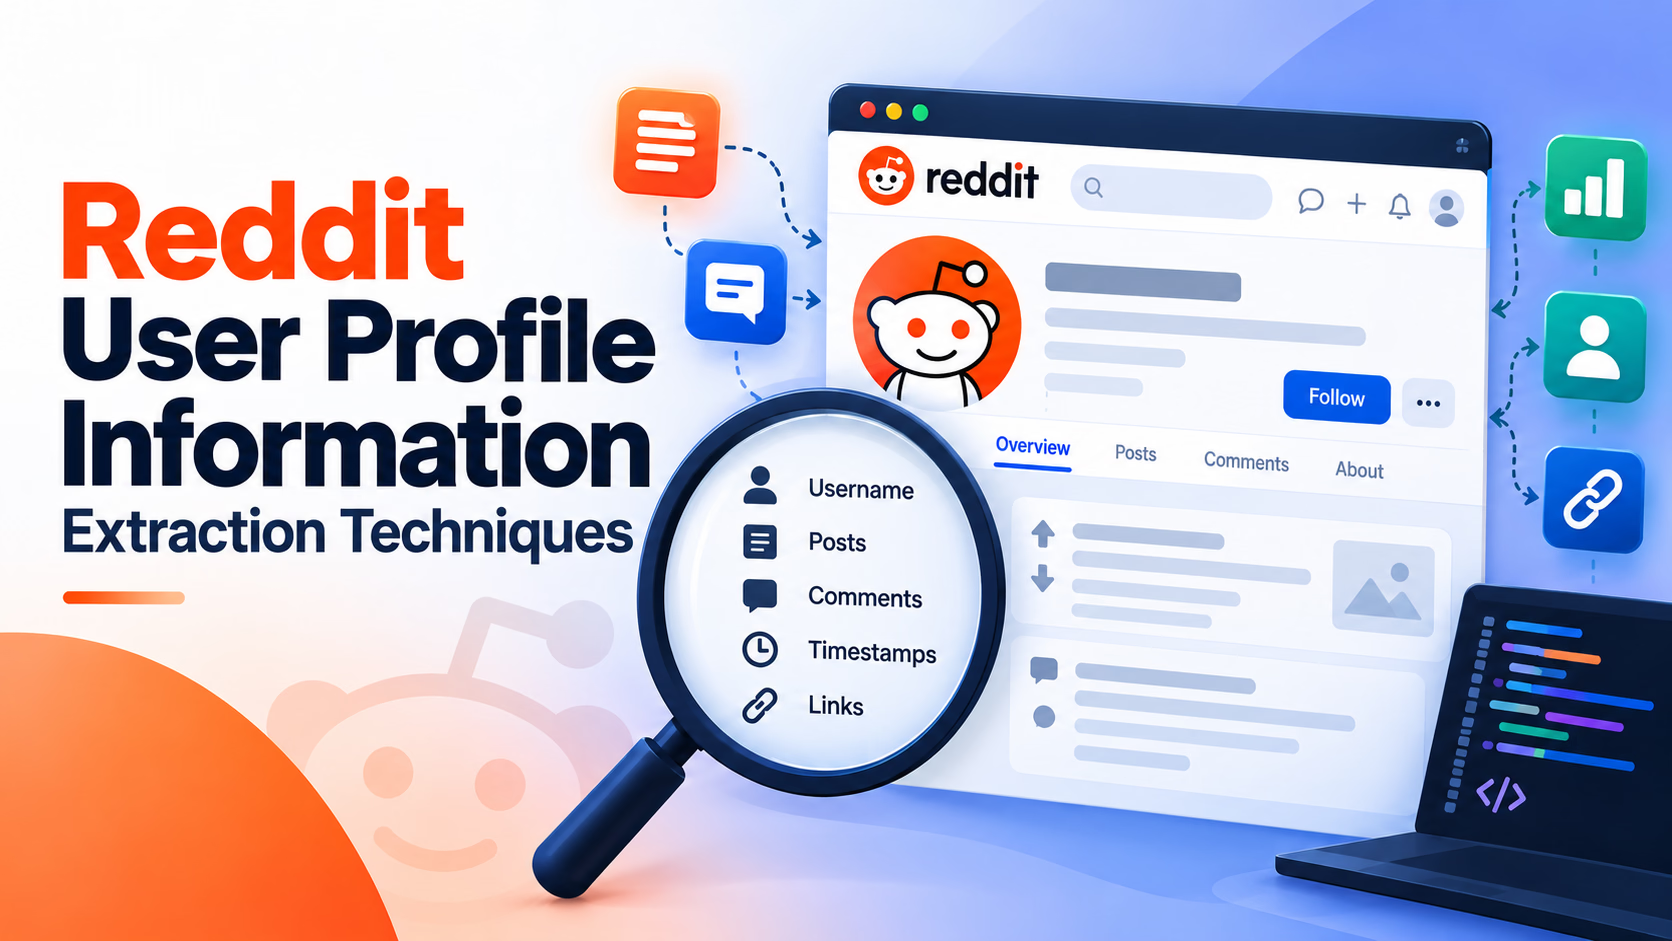
Extraire des informations d’un profil Reddit consiste à constituer un petit relevé vérifiable de l’activité visible d’un compte : contenu, communauté, date et fil de discussion. Ce relevé ne prouve pas l’identité de la personne et ne donne pas le droit de constituer un dossier personnel.
Choisir un accès autorisé
Les conditions ont été revérifiées le 11 octobre 2026. La Responsible Builder Policy demande une approbation explicite avant l’accès API. Les usages commerciaux exigent un accord écrit ; la recherche relève du programme Reddit for Researchers. Un navigateur, requests, BeautifulSoup, Playwright ou PRAW fournit une capacité technique, pas une autorisation de collecte.
Pour quelques éléments, une revue manuelle peut documenter la visibilité et ses limites. Pour une collecte répétée, confirmez d’abord l’accès, son objectif et les règles applicables. Ne passez pas discrètement de la consultation à l’automatisation pour gagner du temps.
Définir la question et la trace
Une question comme « quels problèmes de démarrage ce compte a-t-il mentionnés dans cette communauté en septembre ? » fixe sujet, lieu et période. Elle ne permet pas de conclure quel type de personne utilise le compte.
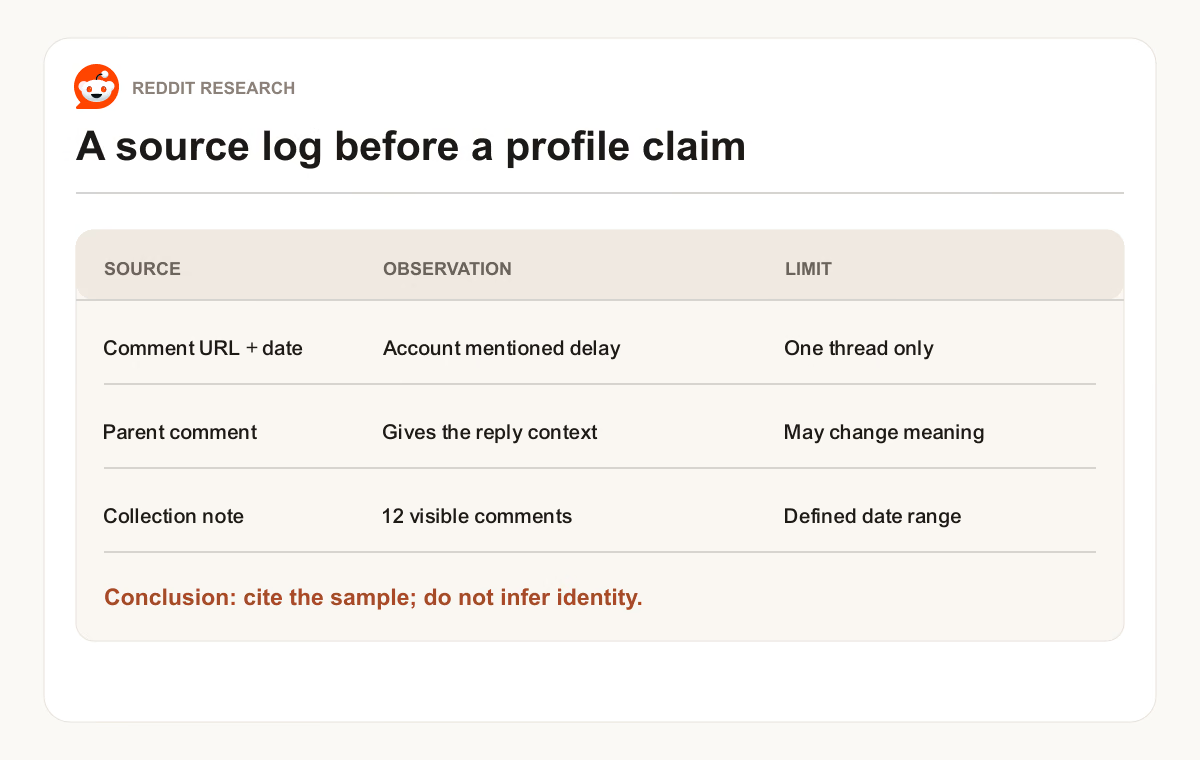
Gardez une ligne par élément pertinent : identifiant, type, communauté, date UTC, permalink, passage utile, date de collecte, contexte et statut de visibilité. Fixez la règle d’inclusion avant de lire les résultats afin d’éviter de sélectionner uniquement ce qui confirme une idée initiale.
Le fil parent donne le sens d’un commentaire. Un score décrit une réaction à un instant donné, pas l’exactitude d’un fait. Séparez les mots du compte des réponses d’autres utilisateurs et limitez les informations personnelles.
Collecter et vérifier dans le périmètre prévu
Pour un accès API approuvé, les routes documentées couvrent le profil, les publications et les commentaires. Enregistrez la route, l’ordre, les curseurs, les dates et les erreurs ; une liste paginée n’est pas un historique certifié complet.
Le wiki exige OAuth et un User-Agent descriptif et honnête. Surveillez les en-têtes de limite et les conditions de votre approbation. Normalisez les dates sans perdre les identifiants et dédupliquez les éléments. Comptez séparément inclusions, exclusions, éléments indisponibles et doublons.
L’exemple Python conservé ci-dessous transforme une réponse déjà autorisée en CSV. Il n’effectue aucune collecte et ne confère aucun droit d’accès. Vérifiez chaque fil et indiquez une valeur manquante plutôt que de l’inventer.
Garder des conclusions limitées
« Six des dix-huit commentaires examinés mentionnent une difficulté » décrit un échantillon fictif. Cela ne prouve pas qu’un utilisateur rencontre habituellement des problèmes techniques. Si les six viennent d’un seul fil, précisez-le.
Recontrôlez les suppressions et retirez les contenus conservés conformément aux règles de Reddit. Un ancien export ne constitue pas un droit permanent de conservation. Un rapport doit garder question, méthode, période, comptes, liens valides et limites.
L’IA peut classer un échantillon autorisé ; vous devez vérifier les comptes et les liens. Ne lui demandez pas d’inférer santé, opinions politiques ou autres caractéristiques sensibles, ni de réidentifier un compte. Ces pratiques sont interdites par la politique actuelle. Les références officielles ci-dessous restent prioritaires si les règles changent.
Exemples et visuels d’origine
import csv
import json
import sys
from datetime import datetime, timezone

listing = json.load(sys.stdin)
writer = csv.DictWriter(sys.stdout, fieldnames=[
    "item_id", "subreddit", "created_utc", "permalink", "observed_text"
])
writer.writeheader()

for child in listing["data"]["children"]:
    item = child["data"]
    body = item.get("body", "")
    if body in ("[deleted]", "[removed]"):
        continue
    writer.writerow({
        "item_id": item["name"],
        "subreddit": item["subreddit"],
        "created_utc": datetime.fromtimestamp(
            item["created_utc"], timezone.utc
        ).isoformat(),
        "permalink": "https://www.reddit.com" + item["permalink"],
        "observed_text": body,
    })
Termes et commandes d’origine
/user/{username}/about
/user/{username}/submitted
/user/{username}/comments
item_id
t1_example123
type
comment
subreddit
examplecommunity
created_utc
2026-09-18T14:25:00Z
permalink
observed_text
collected_at
2026-10-06T09:00:00Z
context_note
status
sample_rule
after
before
limit
X-Ratelimit-Used
X-Ratelimit-Remaining
X-Ratelimit-Reset
created_utc
/submitted
/comments
/comments
requests
/user/{username}/about
/user/{username}/submitted
/user/{username}/comments
Sources et ressources
Mise en pratique
Votre prochaine étape
Vous avez une question ou une correction?
Contacter Thrive