Die Kurzfassung
- Aufgabe definieren → Modellwege prüfen → Fehler verfolgen.
- Bewahre die Quellenbelege auf und prüfe das Ergebnis, bevor du es verwendest.
GPT-6 Sol, Luna und Astra bieten unterschiedliche Optionen für Aufgabenkomplexität und Kosten. OpenAI positioniert Astra für besonders anspruchsvolle Arbeit, Sol für Programmier- und agentische Abläufe und Luna für begrenzte Aufgaben mit hohem Durchsatz. Beginne mit einer bewertbaren Aufgabe und prüfe, welches Modell deine Abnahmekriterien zu vertretbaren Kosten erfüllt.
Die folgenden Spezifikationen beruhen auf offizieller OpenAI-Dokumentation, geprüft am 28. September 2026. Dieser Leitfaden berichtet keinen Thrive-Benchmark und verspricht keine bessere Leistung für deine konkrete Aufgabe.
Vergleiche die veröffentlichten Spezifikationen
Angabe | GPT-6 Luna | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
API-Modell-ID | gpt-6-luna | gpt-6-sol | gpt-6-astra |
Basispreis für Eingaben je Million Tokens | USD 0.10 | USD 2 | USD 10 |
Basispreis für Ausgaben je Million Tokens | USD 0.50 | USD 10 | USD 50 |
Kontextfenster | 1,050,000 Tokens | 1,050,000 Tokens | 1,050,000 Tokens |
Maximale Ausgabe | 128,000 Tokens | 128,000 Tokens | 128,000 Tokens |
Quellen: die offiziellen Seiten für Luna, Sol und Astra. Die Tabelle nutzt Basispreise für Text. Prüfe Caching, Bedingungen für lange Eingaben, Dienststufen, regionale Verarbeitung und Werkzeugkosten vor der Berechnung.
Ein großes Kontextfenster beschreibt eine Kapazitätsgrenze. Es belegt nicht, dass ein Modell sämtliches Material gut nutzt. Teste, ob es die für deine Frage relevanten Belege findet und anwendet.
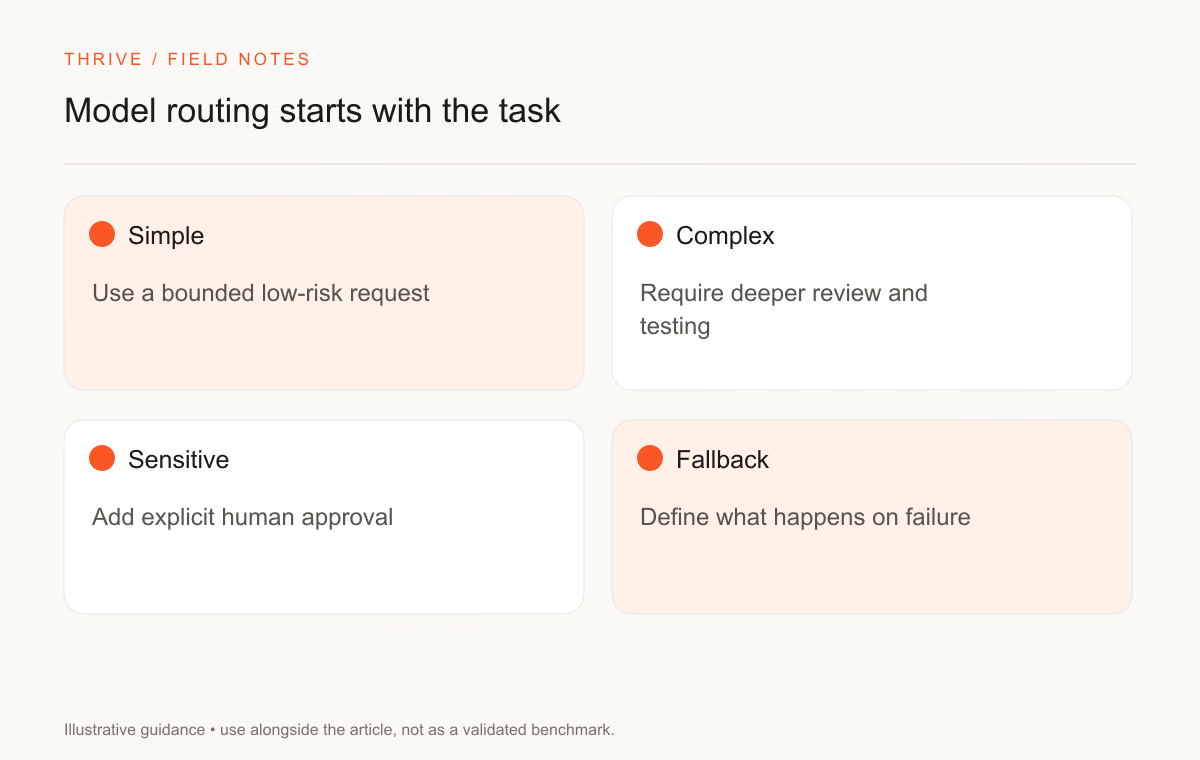
Ordne Modelle nach den Abnahmekriterien zu
Beispielaufgabe | Zuerst zu testender Kandidat | Nachweis vor der weiteren Nutzung |
|---|---|---|
Felder aus einem kurzen Dokument extrahieren | Luna | Gültige Felder, belegte Werte und korrekter Umgang mit fehlenden Angaben |
Eine begrenzte Repository-Änderung umsetzen | Sol | Bestandene Tests und prüfbarer Diff |
Mehrere zusammenwirkende Vorgaben untersuchen | Astra | Belegte Erklärung und Prüfungen wichtiger Fälle |
Einen Lebenslauf-Stichpunkt überarbeiten | Ein begrenzter Vergleich verfügbarer Modelle | Erhaltene Fakten und hilfreiche Formulierungen |
Dies sind vorgeschlagene Testwege, keine gemessenen Ranglisten. Deine Bewertung kann zu einer anderen Wahl führen. Eine sensible Extraktionsaufgabe kann mehr Prüfung benötigen als eine große, risikoarme Schreibaufgabe.
Bewahre Beispiele mit bekannten akzeptablen Ergebnissen auf. Ergänze fehlende Felder, widersprüchliche Anweisungen und ungewöhnliche Eingaben. Eine Enthaltung oder Eskalation kann zulässig sein, wenn die Belege keine Antwort stützen.
Berechne beispielhafte Basiskosten
Für 10,000 nicht gecachte Eingabe-Tokens und 2,000 Ausgabe-Tokens ergeben die Basispreise USD 0.002 für Luna, USD 0.04 für Sol und USD 0.20 für Astra. Dies sind Rechenbeispiele mit festen Token-Zahlen, keine beobachtete Nutzung oder Prognose der Ausgabelänge.
Rechne die für deine Anfrage geltenden Zusatzkosten hinzu. Zähle Wiederholungen und Fehlversuche mit. Vergleiche Gesamtkosten pro geprüfter, akzeptierter Aufgabe, statt den niedrigsten Token-Preis automatisch als niedrigste Arbeitskosten zu betrachten.
Nutze bei Endkunden- oder Coding-Agent-Abonnements die jeweiligen Tarifbedingungen. API-Preise und Abonnementkontingente beschreiben unterschiedliche Abrechnungen.
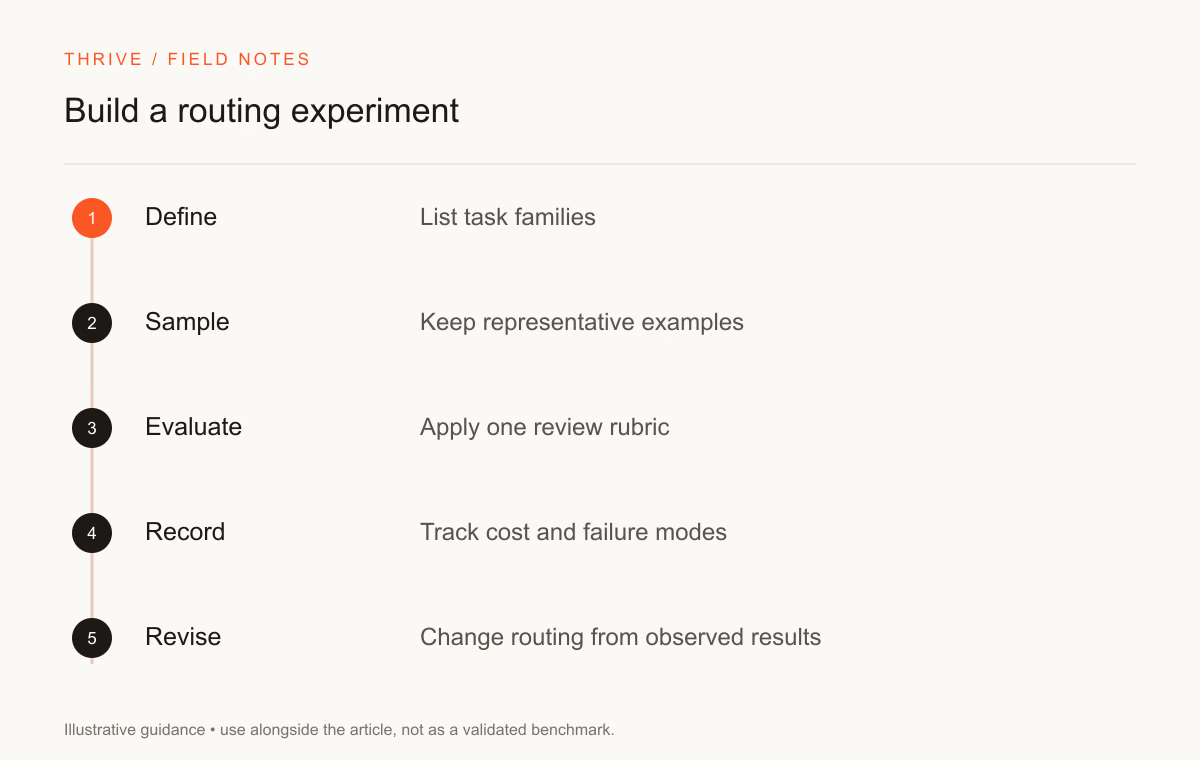
Definiere Eskalationen vor dem Produktivbetrieb
Definiere Bedingungen für ein stärkeres Modell oder menschliche Prüfung. Beispiele sind widersprüchliche Quellenwerte, ein fehlgeschlagener Regressionstest oder fehlende Pflichtzitate.
Bewahre Eingabe und Fehlergrund bei einer eskalierten Aufgabe auf. Ein zweites Modell braucht die problemverursachenden Belege. Die Bitte um eine selbstsicherere Antwort kann Unsicherheit verdecken, ohne sie zu lösen.
Nutze den Ablauf zur Modellbewertung hilft beim Festlegen von Erfolgskriterien, der Prompt zur Prüfung von Ausgabefehlern beim Einordnen von Fehlern. Prüfe das kleinere Modell vor einer Ausweitung erneut an bisher nicht verwendeten Beispielen.
Halte die Bewertung über Updates hinweg vergleichbar
Dokumentiere Modell-ID, Datum, Einstellungen, Eingaben, Werkzeuge, Ausgabe und Prüfentscheidung. Wiederhole repräsentative Fälle bei geändertem Anbieterverhalten oder geänderter Anwendung. Ein Ergebnis aus einer Konfiguration belegt keine Leistung in einer anderen.
Lies für Programmieraufgaben den Leitfaden zur Auswahl einer Programmier-KI. Für einen anbieterübergreifenden Vergleich nutze den Vergleich von Opus 5.5 und Sol.
Bereite ein anonymisiertes Experiment zur Modellzuordnung als Portfolioprojekt auf. Erkläre Abnahmeregeln, beobachtete Fehler und Prüfentscheidungen und beschreibe deinen Beitrag im Lebenslauf-Editor.
Quellen und Aktualisierungshinweise
Thrive Editorial hat diese Quellen am 28. September 2026 geprüft. Prüfe Preise und Kontozugang erneut, bevor du einen Arbeitsumfang festlegst.
Setzen Sie es in die Praxis um
Dein nächster Schritt
Hast du eine Frage oder Korrektur?
Thrive kontaktieren