Die Kurzfassung
- Kleine Aufgabe → Getesteter Diff → Menschliche Prüfung.
- Bewahre die Quellenbelege auf und prüfe das Ergebnis, bevor du es verwendest.
Wähle eine KI zum Programmieren, indem du eine Änderung in einem typischen eigenen Repository testest. Gib dem Assistenten eine konkrete Anforderung, einen festen Code-Stand und einen Testbefehl. Prüfe den Diff und führe die Kontrollen aus, bevor du beurteilst, ob das Werkzeug Arbeit spart.
Ein Modell, ein IDE-Assistent und ein Coding-Agent haben unterschiedliche Zugriffsmöglichkeiten. Ein Agent kann Dateien bearbeiten und Befehle ausführen; ein Chat liefert möglicherweise Code zum Kopieren. Vergleiche den gesamten Ablauf, den du nutzen möchtest.
Beginne mit Modell und zugehörigem Werkzeug
OpenAI beschreibt GPT-6 Sol für Programmier- und agentische Aufgaben, während Astra und Luna andere Kosten- und Leistungsanforderungen bedienen. Anthropic beschreibt Opus 5.5 für agentisches Programmieren und Wissensarbeit. Diese Anbieterbeschreibungen nennen mögliche Kandidaten, bestimmen aber keinen Sieger für dein Repository.
Kandidat | Einordnung des Anbieters | Möglicher Test |
|---|---|---|
GPT-6 Sol | Programmier- und agentische Abläufe | Ein fehlgeschlagener Test und eine begrenzte Implementierung |
GPT-6 Astra | Komplexe Schlussfolgerungen und Programmierung | Eine Änderung mit mehreren zusammenwirkenden Vorgaben |
GPT-6 Luna | Begrenzte Aufgaben mit hohem Durchsatz | Eine eingegrenzte Umwandlung mit automatischen Prüfungen |
Claude Opus 5.5 | Agentisches Programmieren und Wissensarbeit | Eine Repository-Aufgabe mit überprüfbaren Etappen |
Quellen: OpenAIs Modellkatalog und Anthropics Modellübersicht. Prüfe aktuellen Zugang, Nutzungslimits und Preise des gewählten Produkts. Dieser Leitfaden berichtet keine abgeschlossenen Benchmark-Ergebnisse.
Erstelle Tests für dein Repository
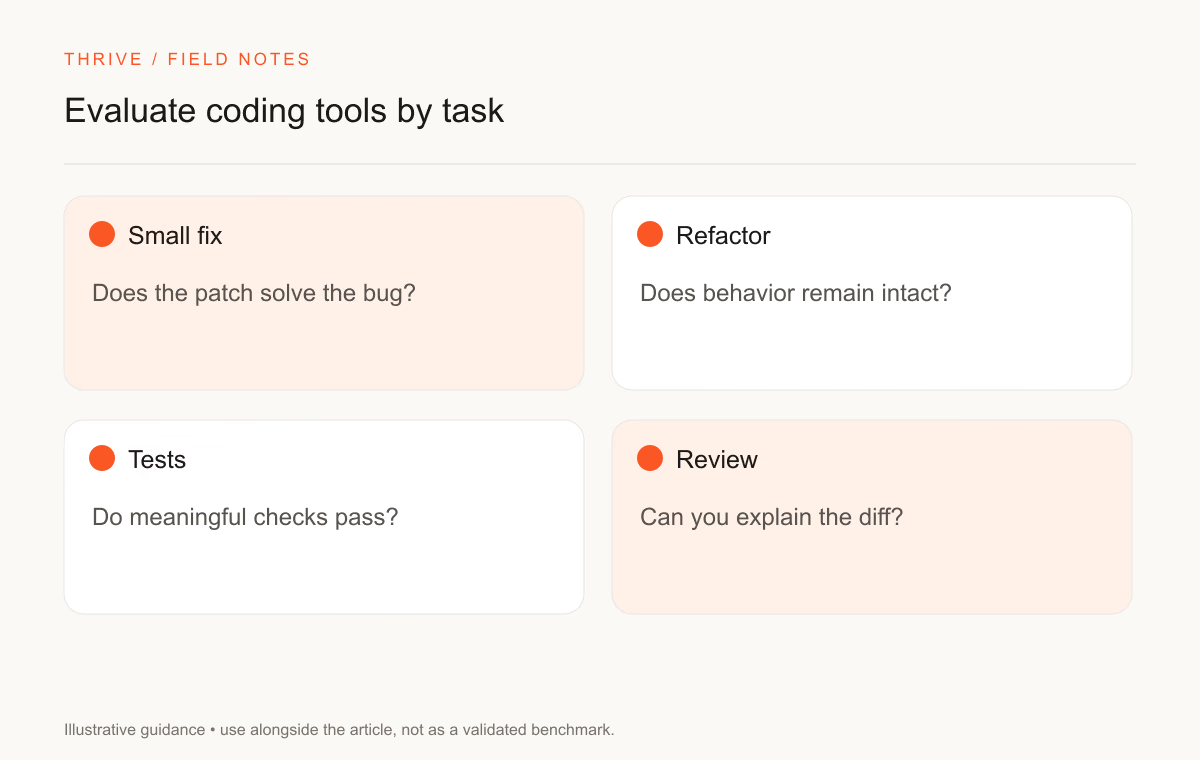
Wähle Beispiele aus wiederkehrenden Aufgaben: einen Fehler, eine kleine Funktion und eine Prüfaufgabe. Ergänze mindestens einen Fall, in dem eine verlockende Abkürzung eine wichtige Vorgabe verletzt.
Nutze einen sauberen Branch und bewahre den Ausgangs-Commit auf. Gib jedem Kandidaten dieselben Anweisungen und erlaubten Werkzeuge. Dokumentiere Modell, Einstellungen für den Denkaufwand, Kontext und ausgeführte Befehle.
Aufgabe | Abnahmeprüfung | Zu dokumentierender Fehler |
|---|---|---|
Fehlerbehebung | Die Reproduktion schlägt vor der Änderung fehl und besteht danach | Der Assistent verdeckt den Fehler |
Funktion | Das gewünschte Verhalten funktioniert und vorhandenes Verhalten bleibt erhalten | Nicht angeforderte API-Änderungen |
Refactoring | Tests und Schnittstellen bleiben stabil | Umfangreichere Änderungen ohne Begründung |
Code-Review | Die Befunde enthalten ein reproduzierbares Problem | Unbelegte Warnungen vor hypothetischen Fehlern |
Dokumentation | Beispiele entsprechen der tatsächlichen API | Erfundene Flags oder Signaturen |
Ein Debugging-Ablauf kann den ersten Fall strukturieren. Nutze für TypeScript den Prompt zur Architekturprüfung, um den Prüfumfang festzulegen.
Halte Berechtigungsgrenzen sichtbar
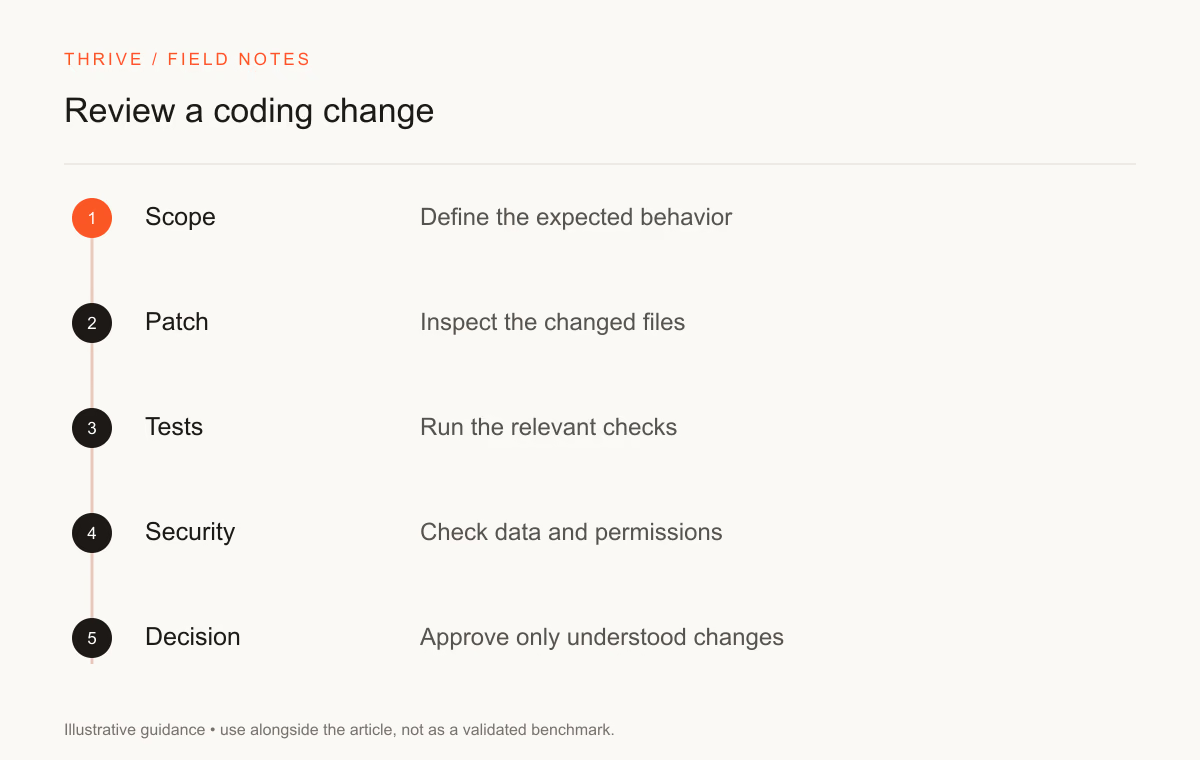
Begrenze den Assistenten auf notwendige Repositorys und Befehle. Halte Zugangsdaten aus Prompts und Protokollen heraus. Prüfe vorgeschlagene Paketinstallationen, Datenbankänderungen oder externe Handlungen, bevor du sie in einer Testumgebung erlaubst.
Lies den Diff, bevor du generierten Code auf sensible Systeme anwendest. Ein bestandener Unit-Test belegt nicht die Sicherheit eines Deployment-Befehls oder einer Datenbankmigration. Trenne lokale Umsetzung und Freigabe zur Veröffentlichung.
Ergänze bei Repositorys mit Nutzerdaten einen Eigentums- oder Berechtigungstest. Eine Funktion kann den Normalfall bestehen und trotzdem einem Konto Zugriff auf die Daten eines anderen geben.
Miss Prüfaufwand und Nutzungskosten
Miss auch die Zeit für Korrekturen, nicht nur die Wartezeit bis zur ersten Antwort. Ein schneller Patch mit viel Nacharbeit kann mehr Aufmerksamkeit kosten als ein langsamerer, brauchbarer. Notiere, wo du Anforderungen erneut erklären musstest.
API-Kosten hängen von Tokens, Dienstbedingungen und Werkzeugen ab. IDE- und Agent-Abonnements können eigene Limits haben. Berechne die Kosten je akzeptierter Aufgabe aus tatsächlicher Nutzung und aktuellen Anbieterpreisen.
Bewahre fehlgeschlagene Versuche im Protokoll auf. Entfernst du sie nach dem Test, wirkt ein Werkzeug zuverlässiger als tatsächlich beobachtet. Halte Gleichstände fest, wenn deine Regeln keine Unterscheidung erlauben.
Wähle einen Standard und einen Eskalationsweg
Wähle nach einem Pilotversuch einen Standard für einen definierten Aufgabenbereich. Ein Kandidat kann kurze Umwandlungen übernehmen, ein anderer schwierige Repository-Untersuchungen. Teste nach Modellupdates oder Änderungen der Codebasis erneut.
Der Programmier-Testplan für Sol und Opus bietet ein detailliertes Vergleichsblatt. Der Leitfaden zur GPT-6-Familie behandelt die Aufgabenverteilung zwischen OpenAIs Modellen.
Bereite eine anonymisierte Bewertung als Portfolioeintrag auf: Aufgabe, Ausgangszustand, Prüfungen und Ergebnis. Nutze den Code-Review-Skill und Lebenslauf-Editor zur Dokumentation deines Beitrags, ohne einen nicht durchgeführten Benchmark zu behaupten.
Quellen und Prüfhinweise
Thrive Editorial hat diese Quellen am 28. September 2026 geprüft. Die Abnahmeprüfungen sind ein eigenständig vorgeschlagener Rahmen und kein Nachweis, dass Thrive die genannten Modelle getestet hat.
Setzen Sie es in die Praxis um
Dein nächster Schritt
Prompt ausprobieren
Prompt-BibliothekTypeScript-Architektur und Typsicherheit prüfenHast du eine Frage oder Korrektur?
Thrive kontaktieren