Die Kurzfassung
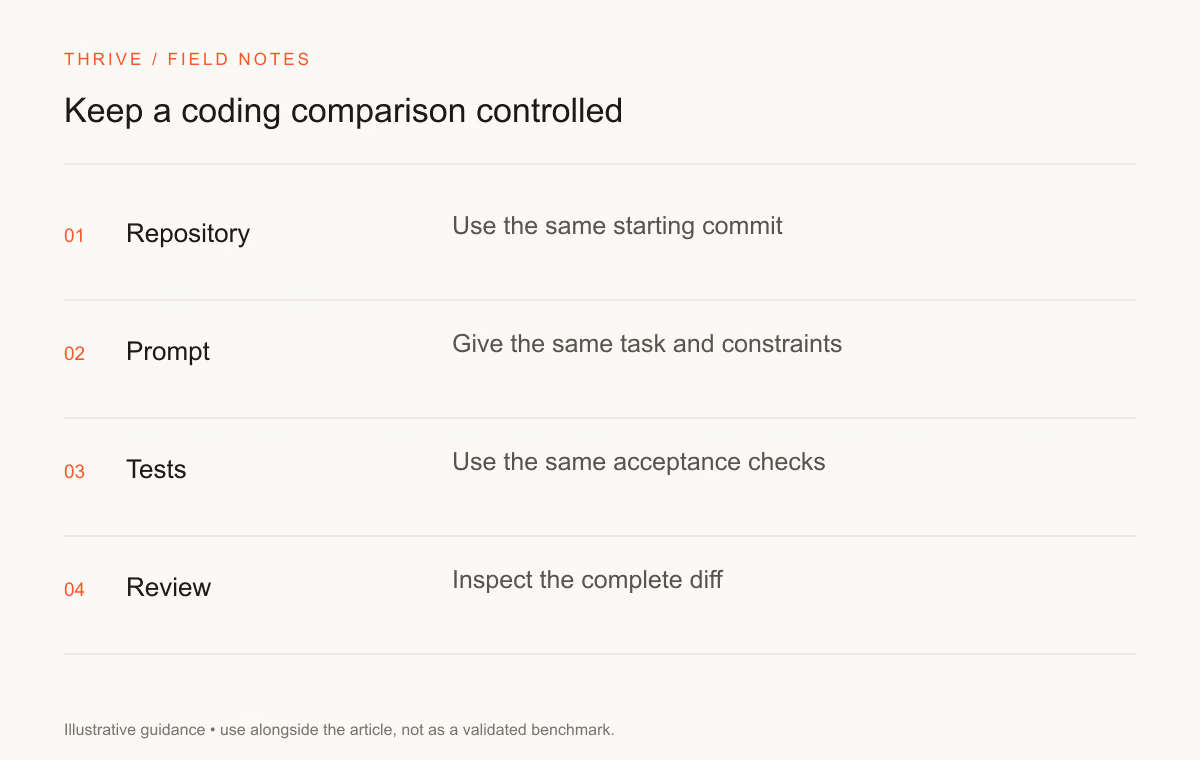
- Gleiches Repository → Gleiche Tests → Geprüfter Diff.
- Bewahre die Quellenbelege auf und prüfe das Ergebnis, bevor du es verwendest.
Vergleiche GPT-6 Sol und Claude Opus 5.5 beim Programmieren an einem festen Repository-Stand. Gib beiden dieselbe Aufgabe, denselben Werkzeugzugriff und dieselben Abnahmeprüfungen. Bewahre Patch, Befehlsprotokoll und Prüfnotizen auf, um das Ergebnis erklären zu können.
Dieser Artikel stellt einen Testplan bereit. Thrive hat diesen direkten Vergleich nicht durchgeführt und veröffentlicht keine erfundenen Werte. Offizielle Spezifikationen liefern Ausgangsinformationen; deine Aufgaben liefern die Entscheidungsgrundlage.
Bereite einen fairen Vergleich vor
Wähle ein Repository, das du verwenden darfst, und entferne Secrets aus der Testumgebung. Notiere den Commit-Hash und stelle den Ausgangszustand vor jedem Durchlauf wieder her. Halte für Fehleraufgaben eine fehlschlagende Reproduktion bereit.
Gib dieselben Anweisungen, relevanten Dateien und erlaubten Befehle vor. Definiere Zeit- oder Versuchslimit und Prüfkriterien vor dem Durchlauf. Bekommt ein Produkt zusätzliche Abfragewerkzeuge, dokumentiere den Unterschied und bezeichne den Test als Ablaufvergleich.
Nutze einen Testbranch. Halte Produktivzugangsdaten und Deployments aus dem Test heraus. Zum Nachweis eines lokalen Patches sollte der Assistent weder Nachrichten senden, Pakete veröffentlichen noch eine Live-Datenbank ändern müssen.
Nutze fünf Aufgabenarten
Aufgabe | Ausgangsmaterial | Abnahmeregel | Ergebnisfeld |
|---|---|---|---|
Debugging | Eine fehlschlagende Reproduktion | Behebt die Ursache und ergänzt eine relevante Regressionsprüfung | Nach dem Durchlauf eintragen |
Refactoring | Funktionierender Code und stabile Schnittstellen | Erhält Verhalten und öffentliche Schnittstellenverträge | Nach dem Durchlauf eintragen |
Tests | Eine Anforderung mit bekannten Grenzfällen | Prüft Verhalten und macht einen relevanten Fehler sichtbar | Nach dem Durchlauf eintragen |
Repository-Analyse | Eine begrenzte Architekturfrage | Zitiert relevante Dateien und folgt dem tatsächlichen Aufrufpfad | Nach dem Durchlauf eintragen |
Dokumentation | Eine aktuelle API oder ein aktueller Befehl | Beispiele laufen gegen die angegebene Version | Nach dem Durchlauf eintragen |
„Nach dem Durchlauf eintragen“ ist eine Arbeitsblattbeschriftung, kein Leistungsergebnis. Ergänze relevante Repository-Aufgaben, etwa Berechtigungsprüfungen oder Migrationsreviews.
Formuliere konkrete Aufgabenvorgaben
Beschreibe Eingabe, erwartetes Verhalten, Vorgaben und Prüfbefehl. Ein hilfreicher Fehlerauftrag nennt die Nutzerhandlung, das beobachtete und das erwartete Ergebnis. Füge nach Möglichkeit Fehlermeldung oder Reproduktion hinzu.
For a fictional application, a task might be: “When a signed-out visitor opens the private resume workspace, send them to sign-in and preserve the requested destination. Signed-in visitors should open the workspace. Keep public resume guidance accessible.” That defines two states and a boundary a reviewer can test.
Lass den Assistenten vor einer Ausweitung erklären, welche Dateien er ändern will. Ein Repository-Refactoring braucht eine Begründung, die zum angeforderten Verhalten passt.
Nutze den Prompt zur TypeScript-Prüfung für einen Review-Fall und den Debugging-Skill für einen Fall mit Fehlerreproduktion.
Prüfe ohne sichtbaren Modellnamen
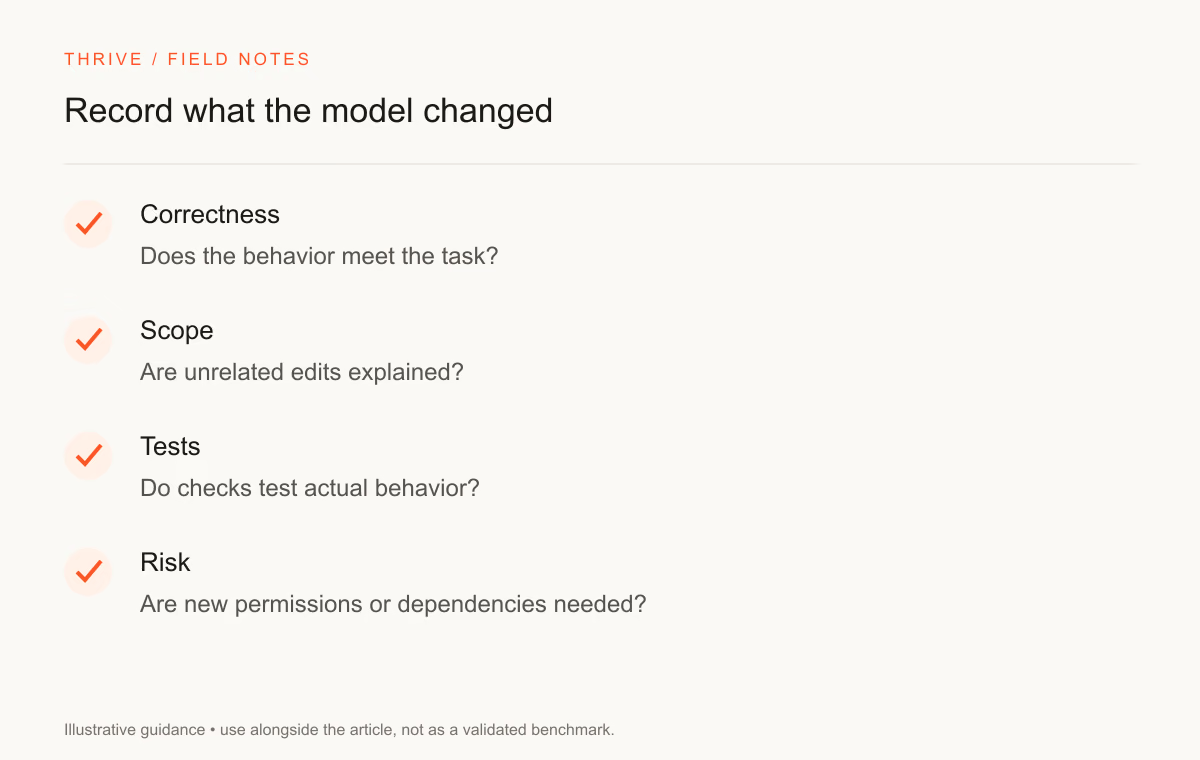
Gib Prüfenden die Patches nach Möglichkeit unter neutralen Namen. Lass Korrektheit, Umfang, Wartbarkeit und Prüfung beurteilen. Bewahre einen Gleichstand, wenn beide Patches bei ähnlichem Prüfaufwand die Vorgaben erfüllen.
Führe die Testsuite in einer sauberen Umgebung aus. Prüfe, ob der Assistent Tests abgeschwächt, Fehler unterdrückt oder Einstellungen zum Bestehen verändert hat. Dokumentiere Fehler und vorgeschlagene Korrektur als getrennte Belege.
Prüfe Abhängigkeiten und Berechtigungsänderungen. Eine Lösung des sichtbaren Fehlers durch erweiterten Zugriff kann ein schwereres Problem erzeugen. Prüfende sollten verstehen, warum jede sensible Änderung zur Lösung gehört.
Berechne Kosten aus der tatsächlichen Nutzung
Notiere Eingabe- und Ausgabe-Tokens, Wiederholungen, Werkzeugkosten und Prüfzeit. Nutze den für die konkrete Anfrage geltenden Anbieterpreis. Der allgemeine Modellvergleich erklärt Basisspezifikationen und ein begrenztes Rechenbeispiel.
Vergleiche Kosten je akzeptierter Aufgabe, nicht nur Token-Preise. Ein Modell kann mehr Kontext oder Versuche benötigen. Tokenizer und Dienststufen können die Rechnung scheinbar ähnlicher Sitzungen verändern.
Beschreibe Ergebnisse und ihre Grenzen
Nenne Modell-IDs, Einstellungen, Repository-Version, Aufgabenzahl, Versuchsregeln, Datum und Prüfmethode. Erkläre Fehler ebenso wie Erfolge. Begrenze die Aussage auf getestete Aufgaben, ohne auf sämtliche Programmierarbeit zu schließen.
Bewahre das Originalprotokoll auf. Leser sollten die Prüfungen wiederholen oder nachvollziehen können, warum ein Fall scheiterte. Wiederhole wichtige Fälle nach Modell- oder Agent-Werkzeugänderungen.
Der Ablauf zur Modellbewertung und Bewertungsraster für paarweise Vergleiche hilft beim Ordnen der Prüfung. Eine anonymisierte Fassung kann ein Portfoliogespräch über deine Testentscheidungen unterstützen.
Quellen und Prüfhinweise
Thrive Editorial hat diese Quellen am 28. September 2026 geprüft. Wir haben das Arbeitsblatt gestaltet, aber keine gemessenen Modellergebnisse eingetragen.
Setzen Sie es in die Praxis um
Dein nächster Schritt
Hast du eine Frage oder Korrektur?
Thrive kontaktieren