Die Kurzfassung
- Gleiche Eingabe → Verdeckte Bewertung → Gemessene Kosten.
- Bewahre die Quellenbelege auf und prüfe das Ergebnis, bevor du es verwendest.
Claude Opus 5.5 und GPT-6 Sol können Programmier- und Wissensarbeit unterstützen. Wähle anhand deiner tatsächlichen Aufgaben, mit denselben Eingaben und Prüfregeln. Spezifikationen nennen Zugangsgrenzen und Token-Preise, entscheiden aber nicht, welches Modell dein Projekt besser bearbeitet.
Thrive hat die offizielle Dokumentation am 28. September 2026 geprüft. Dies ist ein Spezifikationsvergleich mit Bewertungsleitfaden. Wir haben keinen direkten Benchmark durchgeführt; die Tabellen enthalten keine erfundenen Leistungswerte.
Vergleiche die veröffentlichten API-Spezifikationen
Angabe | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
Anbieter | OpenAI | Anthropic |
API-Modell-ID | gpt-6-sol | claude-opus-5-5 |
Kontextfenster | 1,050,000 Tokens | 1,000,000 Tokens |
Maximale Ausgabe | 128,000 Tokens | 128,000 Tokens |
Basispreis für Eingaben je Million Tokens | USD 2 | USD 4 |
Basispreis für Ausgaben je Million Tokens | USD 10 | USD 20 |
Quellen: OpenAIs Sol-Spezifikation, Anthropics Modellübersicht und Anthropics API-Preise. Diese Basispreise enthalten keine Werkzeugkosten, Caching, Dienststufen, regionalen Preise oder weiteren Bedingungen. OpenAI berechnet höhere Preise oberhalb seiner dokumentierten Grenze für lange Eingaben. Prüfe die Abrechnungsbedingungen deiner Aufgabe vor der Budgetplanung.
API-Preise sind von Endkunden-Abonnements getrennt. Ein ChatGPT- oder Claude-Tarif bietet keine unbegrenzte API-Nutzung zu den Tabellenpreisen. Prüfe das tatsächlich verwendete Produkt und Konto.
Miss die Kosten einer abgeschlossenen Aufgabe
Token-Preise helfen bei einer ersten Schätzung. Die tatsächlichen Aufgabenkosten umfassen auch Wiederholungen und deine Prüfzeit.
Bei einer beispielhaften Anfrage mit 10,000 nicht gecachten Eingabe-Tokens und 2,000 Ausgabe-Tokens betragen die Basiskosten für Text USD 0.04 bei Sol und USD 0.08 bei Opus 5.5. Die Rechnung nutzt die Tabellenpreise und setzt keine Zusatzkosten voraus. Dies sind Rechenbeispiele, keine beobachteten Rechnungen oder Prognosen zur Ausgabelänge.
Bewahre für jeden Test die Nutzungsantwort des Anbieters auf. Zwei Tokenizer können dasselbe Dokument unterschiedlich zählen. Ein Modell mit längerer Ausgabe kann mehr kosten, als dein Beispiel mit fester Ausgabelänge vermuten lässt.
Teste deine tatsächlichen Aufgaben
Aufgabe | Eingaben für beide Modelle | Prüfpunkte |
|---|---|---|
Code-Änderung | Derselbe Repository-Stand und fehlgeschlagene Test | Korrektes Verhalten, minimale Änderungen und bestandene Prüfungen |
Rechercheübersicht | Dasselbe Quellenmaterial und dieselbe Frage | Belegte Aussagen und korrekte Zitate |
Lebenslaufbearbeitung | Dieselben geprüften Fakten und dieselbe Stellenbeschreibung | Erhaltene Fakten und sinnvolle Kürzungen |
Prüfung langer Dokumente | Dasselbe Dokument und dieselben Fragen | Belege aus relevanten Abschnitten und benannte Lücken |
Agentischer Ablauf | Dieselben Werkzeuge und Berechtigungsgrenzen | Sichere Handlungen, Wiederherstellung und brauchbares Prüfprotokoll |
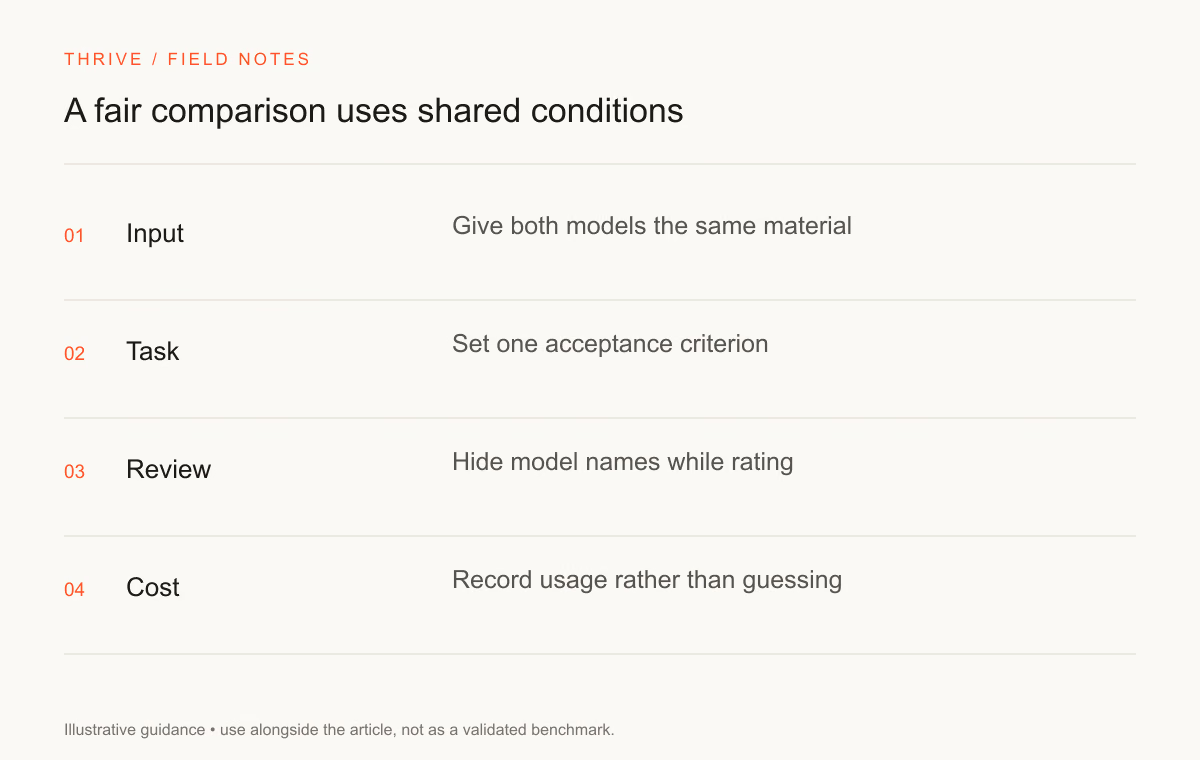
Lege Abnahmekriterien vor dem Lesen der Antworten fest. Bei Lebensläufen sollten ergänzte Fakten zur Ablehnung führen, auch wenn der Text überzeugend klingt. Beim Programmieren ersetzt eine selbstsichere Erklärung keinen bestandenen Test.
Nutze den Prompt für paarweise Bewertung hilft beim Strukturieren eines ersten Vergleichs. Verberge nach Möglichkeit die Modellnamen vor den Prüfenden und bewahre Gleichstände auf. Notiere Einstellungen und Werkzeugzugriff neben dem Ergebnis.
Trenne Produktfunktionen und Modellverhalten
Eine Web-App kann Suche, Dateiabfrage, Verbindungen und Dokumentexport um ein Modell herum anbieten. Bei einem App-Vergleich gehören diese Funktionen zur Bewertung. Bei einem Modellvergleich solltest du die umgebenden Werkzeuge konstant halten.
Prüfe bei Recherchen, ob der Assistent die Quelle geöffnet hat und die zitierte Stelle seine Aussage stützt. Bestätige bei Bewerbungen Arbeitgeber und aktuelle Anzeige selbst. Kein Modell sollte Qualifikationen erfinden oder eine Bewerbung ohne deine Prüfung versenden.
Der Arbeitsleitfaden zu Claude und ChatGPT behandelt Entscheidungen auf Produktebene. Der Programmiervergleich bietet einen engeren Testplan für Repositorys.
Wähle nach einem kleinen Pilotversuch
Wähle repräsentative Aufgaben, darunter einen erwarteten Fehlerfall. Vergleiche Abnahmequote, Prüfaufwand und tatsächliche Nutzungskosten. Wiederhole wichtige Fälle nach Updates. Ein kleiner Pilot liefert lokale Belege und bestimmt keinen allgemeinen Sieger.
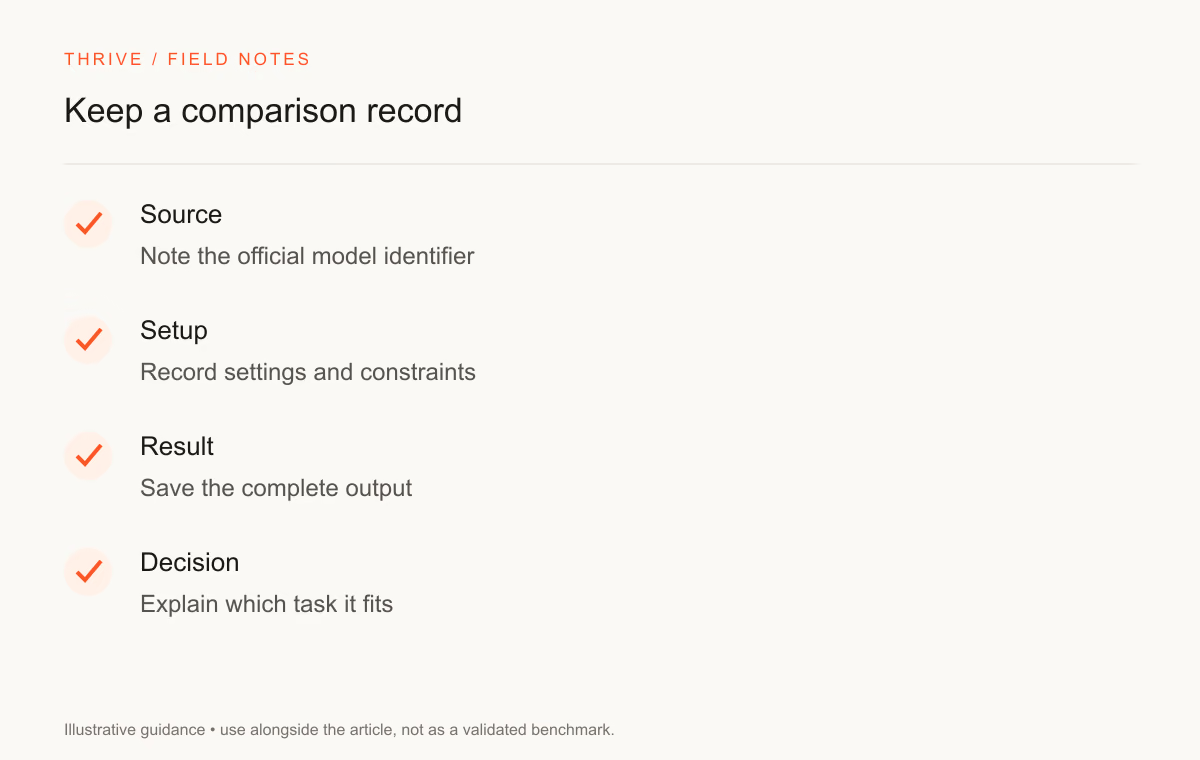
Speichere Prompt, Quellenmaterial, Modell-ID, Datum und Prüfnotizen. Nutze den Skill zur Modellbewertung zum Ordnen des Protokolls und bereite eine anonymisierte Fassung als Portfolionachweis auf.
Quellen und Aktualisierungsregeln
Thrive wird diese URL bei einer geprüften Spezifikationsänderung aktualisieren. Prüfe Preise und Verfügbarkeit erneut vor Kauf oder Migration.
Setzen Sie es in die Praxis um
Dein nächster Schritt
Hast du eine Frage oder Korrektur?
Thrive kontaktieren