La versión breve
- Reddit exige autorización para Data API; la visibilidad pública no autoriza el scraping.
- Registra enlaces permanentes, fechas, contexto y estado de retirada de cada observación.
- Un perfil es un registro parcial de actividad, no prueba de identidad ni de rasgos sensibles.
Extraer información de un perfil de Reddit consiste en convertir la actividad visible de una cuenta en un registro pequeño y comprobable: qué publicó, dónde, cuándo y en qué hilo. Para una revisión ocasional, examina el perfil público y guarda enlaces pertinentes. Para una recogida repetible, obtén el acceso que exige Reddit antes de usar su Data API. Ningún método demuestra quién maneja la cuenta ni autoriza a crear un expediente personal.
Las reglas de acceso de Reddit cambian. Los detalles siguientes se comprobaron el 6 de octubre de 2026; consulta de nuevo las condiciones enlazadas antes de empezar.
Elige la vía de recogida antes que la herramienta
Una biblioteca de Python y un navegador pueden leer páginas, pero no conceden los derechos de una aplicación de API autorizada. El Acuerdo del usuario de Reddit prohíbe el scraping sin consentimiento previo por escrito. Su Política de creadores responsables exige aprobación explícita para acceder a Data API. Renderizar una página con Playwright no cambia esas condiciones.
Vía | Para qué sirve | Qué comprobar primero | Limitación principal |
|---|---|---|---|
Revisión manual en Reddit | Unos pocos mensajes o comentarios públicos pertinentes | Visibilidad y si se permite el uso previsto | Lenta; es fácil perder contexto |
Acceso autorizado a Data API | Flujos de aplicación repetibles y acotados | Aprobación, credenciales OAuth, uso permitido, límites y eliminaciones | Listas paginadas y posibles restricciones de acceso |
Reddit for Researchers | Investigación no comercial autorizada | Admisión y condiciones de investigación | La política actual no permite investigar con datos recogidos fuera del programa |
Scraping de HTML o automatización de navegador | Un uso autorizado por separado | Permiso escrito y alcance exacto | Estructura de página frágil; automatizar no elude la política |
El uso comercial de datos de Reddit requiere aprobación explícita por escrito. La Política de creadores responsables dirige a los investigadores al programa Reddit for Researchers. Antes de crear un recolector, define si haces una herramienta de moderación, una revisión de tu cuenta, investigación o una aplicación comercial.
Qué puede decirte un perfil público
Un perfil visible puede mostrar nombre de cuenta, descripción, publicaciones, comentarios, comunidades, fechas, puntuaciones y enlaces. La disponibilidad varía por cuenta y acceso. La referencia de API documenta /user/{username}/about para información de cuenta, y /user/{username}/submitted y /user/{username}/comments para listas de actividad. Los endpoints describen datos de la cuenta. No verifican nombre real, ubicación, empresa ni creencias privadas de una persona.
El enlace permanente y el hilo suelen importar más que una exportación extensa. Una respuesta como «ha vuelto a fallar» apenas significa nada sin el comentario anterior. Una puntuación alta refleja reacción de lectores en un momento, no exactitud. Distingue las palabras de la cuenta de las respuestas ajenas.
Haz rastreable cada observación
Crea una fila por elemento pertinente. Los datos siguientes son ejemplos ficticios de estructura, no hallazgos sobre una cuenta real.
Campo | Ejemplo | Por qué guardarlo |
|---|---|---|
|
| Eliminar duplicados y comprobar retiradas posteriores |
|
| Distinguir respuestas de publicaciones |
|
| Conservar el contexto del hilo |
|
| Definir el periodo de actividad |
| Enlace al comentario | Permitir al revisor examinar el hilo |
| «El correo de configuración llegó tarde» | Recoger solo el pasaje necesario |
|
| Distinguir fecha de publicación y fecha de revisión |
| Respuesta a una pregunta de incorporación | Evitar que una cita aislada cambie de significado |
| Visible al comprobarlo | Señalar ediciones o retiradas en una nueva revisión |
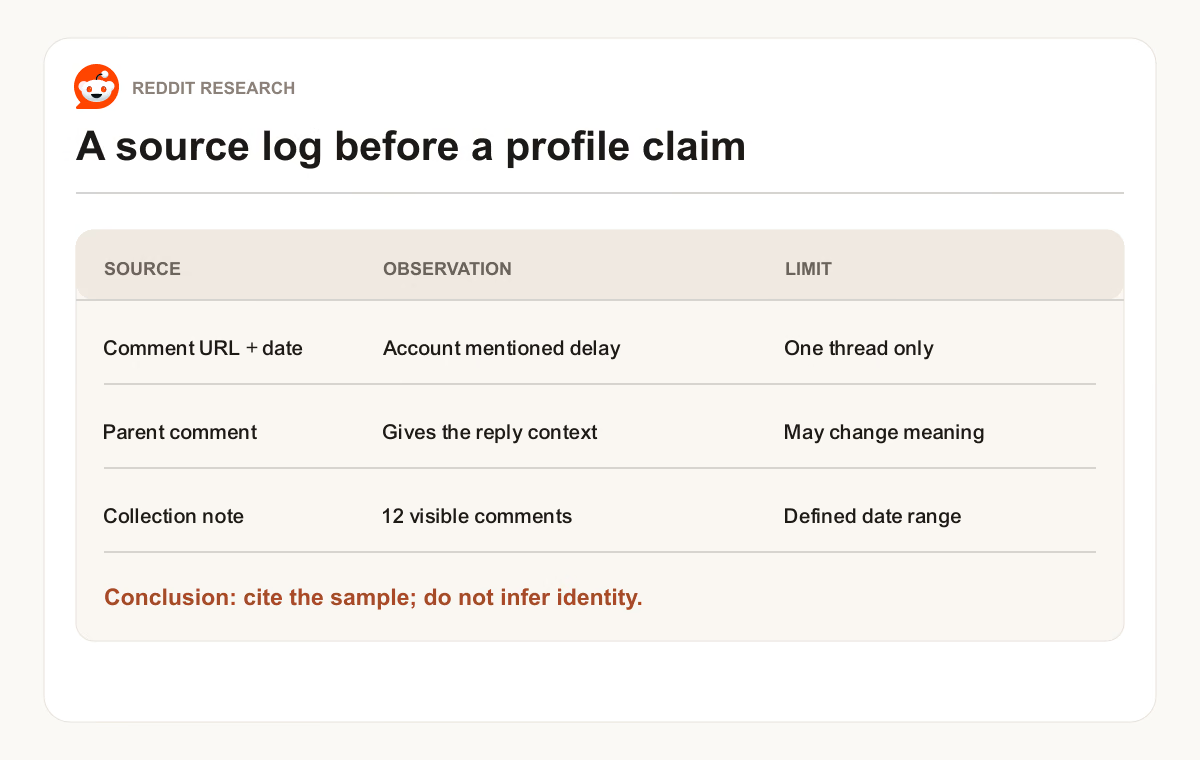
Define una sample_rule para el proyecto, como «comentarios visibles de una comunidad durante septiembre sobre incorporación». Sin una regla es fácil recoger solo publicaciones que apoyen una sospecha inicial. Excluye los datos personales ajenos a la pregunta.
Un flujo práctico de extracción
1. Formula una pregunta acotada
«¿Qué problemas de incorporación mencionó esta cuenta en r/examplecommunity durante septiembre?» delimita tema, comunidad y periodo. «¿Qué tipo de persona hay detrás?» no puede responderse con un registro de actividad. Anota el propósito y la vía de acceso junto a la pregunta.
2. Confirma el acceso y registra el método
Para un flujo de API, solicita la aprobación exigida por la Política de creadores responsables. La wiki de Data API exige un token OAuth registrado y un User-Agent veraz y distintivo. Puede bloquear tráfico sin identificar. Recomendar un script que finja ser un navegador es incorrecto, aunque devuelva una página.
Para unos pocos elementos revisados a mano, anota que utilizaste la interfaz pública y cuándo. Registra las lagunas de visibilidad. No pases silenciosamente a captura automática porque la revisión manual resulte tediosa.
3. Recoge la muestra pertinente más pequeña
Con acceso autorizado, los endpoints documentados devuelven datos estructurados. La documentación de listas utiliza cursores after y before en lugar de números de página y documenta un máximo de limit de 100 elementos por respuesta. Registra endpoint, orden, cursor, hora de recogida y errores. Detente en el límite definido. Una lista es una parte accesible de la actividad, no un historial completo certificado.
Vigila las cabeceras X-Ratelimit-Used, X-Ratelimit-Remaining, y X-Ratelimit-Reset de respuesta. La wiki de API describe actualmente un límite de 100 consultas por minuto para clientes OAuth con acceso gratuito admitido, promediado durante un intervalo. Tu autorización puede imponer otro límite; respeta el aplicable.
4. Normaliza sin perder la fuente
Convierte created_utc en una marca de tiempo UTC coherente. Guarda el ID original y el enlace permanente. Indica si la fila procede de /submitted o de /comments: un título y una respuesta constituyen pruebas distintas. Elimina duplicados por ID entre ejecuciones. Cuenta por separado elementos incluidos, excluidos, no disponibles y duplicados.
Si ya tienes una respuesta de lista /comments autorizada, este ejemplo de Python la convierte en un CSV revisable. Lee JSON de la entrada estándar y escribe CSV en la salida estándar. No recoge datos, concede acceso ni comprueba eliminaciones posteriores.
import csv
import json
import sys
from datetime import datetime, timezone

listing = json.load(sys.stdin)
writer = csv.DictWriter(sys.stdout, fieldnames=[
    "item_id", "subreddit", "created_utc", "permalink", "observed_text"
])
writer.writeheader()

for child in listing["data"]["children"]:
    item = child["data"]
    body = item.get("body", "")
    if body in ("[deleted]", "[removed]"):
        continue
    writer.writerow({
        "item_id": item["name"],
        "subreddit": item["subreddit"],
        "created_utc": datetime.fromtimestamp(
            item["created_utc"], timezone.utc
        ).isoformat(),
        "permalink": "https://www.reddit.com" + item["permalink"],
        "observed_text": body,
    })
Ejecútalo solo con la respuesta autorizada y dentro de las reglas de conservación del proyecto. Examina el hilo de cada enlace retenido antes de afirmar algo. Si falta un campo, registra la limitación sin inventar un valor.
Imagina una revisión acotada de 18 comentarios visibles, seis sobre dificultades de configuración. «Seis de los 18 comentarios revisados mencionan dificultades de configuración» describe esa muestra ficticia. «El usuario tiene problemas frecuentes con la tecnología» convierte un recuento de temas en una afirmación personal. Si los seis pertenecen al mismo hilo, indícalo.
5. Revisa las retiradas y limita el resultado
La wiki de Data API exige eliminar contenido que se haya borrado de Reddit y recomienda borrar habitualmente los datos guardados en un plazo de 48 horas. La Política de creadores responsables pide a investigadores autorizados repetir consultas con exportaciones actuales para reflejar retiradas. Incluye esa comprobación en los flujos continuos. Un CSV antiguo no otorga derecho permanente a retener texto eliminado.
En el informe conserva pregunta, método, periodo, recuentos, enlaces vigentes y límites de la muestra. Comparte texto original solo cuando sea necesario y permitido. Si desaparece un elemento, retira el contenido guardado y revisa los hallazgos que dependan de él.
Dónde encajan las herramientas habituales
requests y BeautifulSoup analizan HTML. Playwright renderiza páginas. PRAW facilita partes de la API de Reddit. Son capacidades técnicas, no permisos de acceso. Para automatizar este tema, empieza por un flujo autorizado de Data API. Si tienes permiso escrito aparte para scraping, documéntalo y respeta el alcance. Los fragmentos de búsqueda pueden mostrar una URL pública, pero ser incompletos u obsoletos; no sustituyen un registro actual.
Un asistente de IA puede clasificar una muestra autorizada y acotada tras recogerla. Proporciona enlaces, pregunta e instrucciones para distinguir inferencia y observación. Verifica tú los recuentos y enlaces. No le pidas deducir identidad, salud, política u otros rasgos sensibles del historial: la Política de creadores responsables prohíbe expresamente ese perfilado.
La skill gratuita Reddit Profile Research proporciona una lista reutilizable basada en fuentes. La skill Research Summarizer organiza varias fuentes permitidas cuando el registro está completo.
Preguntas frecuentes
¿Puedo hacer scraping de un perfil público con Python?
La visibilidad pública no autoriza el scraping. El Acuerdo del usuario restringe la recogida y prohíbe el scraping sin consentimiento previo escrito. Utiliza revisión manual permitida u obtén aprobación para API u otra vía autorizada. Python procesa datos que puedes recoger; la biblioteca no decide los derechos de acceso.
¿Qué endpoints muestran actividad del perfil?
La referencia de API documenta /user/{username}/about, /user/{username}/submitted, y /user/{username}/comments. El acceso depende de aprobación actual, OAuth, comportamiento del endpoint y condiciones. Las listas usan cursores: documenta paginación y regla de parada.
¿El historial identifica a quien maneja la cuenta?
Muestra lo publicado por una cuenta visible durante el periodo revisado. No verifica quién la manejaba. Nombres parecidos, descripciones y patrones pueden inducir a error y causar daño. Limita las conclusiones a la cuenta y el contenido.
¿Qué pasa si se borra una publicación después?
Elimina el contenido borrado y los datos identificativos relacionados según las instrucciones de eliminación de Reddit. Revisa el informe si ese elemento respaldaba un hallazgo. No uses una copia guardada para reconstruir la retirada.
Llévalo a la práctica
Tu siguiente paso
¿Tienes una pregunta o una corrección?
Contactar con Thrive