La versione breve
- Reddit richiede l'approvazione per l'accesso alla Data API; la visibilità pubblica non autorizza lo scraping.
- Per ogni osservazione, registra permalink, date e ore, contesto e stato delle rimozioni.
- Un profilo è un registro parziale delle attività, non una prova dell'identità o di caratteristiche sensibili.
Raccogliere informazioni da un profilo Reddit significa registrare attività visibili e verificabili: cosa è stato pubblicato, dove, quando e in quale discussione. Per una verifica occasionale, consulta il profilo e conserva i link pertinenti. Per raccolte ripetute, ottieni l'accesso richiesto da Reddit. Questi dati non identificano chi gestisce l'account né autorizzano la creazione di un dossier personale.
Le regole di accesso a Reddit cambiano. I dettagli riportati qui sono stati verificati il 6 ottobre 2026; rileggi i termini collegati prima di avviare un progetto.
Scegli il metodo di raccolta prima dello strumento
Una libreria Python e un browser possono entrambi leggere una pagina web. Non conferiscono gli stessi diritti di un'applicazione API approvata. L'attuale Accordo con gli utenti di Reddit vieta lo scraping senza previo consenso scritto. La Responsible Builder Policy richiede un'approvazione esplicita per accedere alla Data API. Visualizzare una pagina con Playwright non cambia queste condizioni.
Modalità di accesso | Utile per | Da verificare prima | Limite principale |
|---|---|---|---|
Consultazione manuale su Reddit | Alcuni post o commenti pubblici pertinenti | Visibilità e ammissibilità dell'uso previsto | Lenta; è facile perdere il contesto |
Accesso approvato alla Data API | Flussi applicativi ripetibili con un ambito definito | Approvazione, credenziali OAuth, usi consentiti, limiti delle richieste, cancellazioni | Elenchi paginati e possibili restrizioni di accesso |
Reddit for Researchers | Ricerca non commerciale approvata | Ammissione al programma e termini per la ricerca | La politica attuale vieta l'uso, per la ricerca, di dati raccolti al di fuori del programma |
Scraping HTML o automazione del browser | Un uso autorizzato separatamente | Permesso scritto e relativo ambito preciso | Struttura delle pagine fragile; l'automazione non aggira le regole |
L'uso commerciale dei dati di Reddit richiede un'approvazione scritta esplicita. La Responsible Builder Policy indirizza i ricercatori al programma Reddit for Researchers. Prima di scrivere un programma di raccolta, stabilisci se stai creando uno strumento di moderazione, controllando il tuo account, svolgendo ricerca o sviluppando un'applicazione commerciale.
Quali informazioni offre un profilo pubblico
Un profilo visibile può mostrare nome dell'account, testo del profilo, post, commenti, community, date, punteggi e link alle discussioni. La disponibilità varia in base all'account e all'accesso. La documentazione API di Reddit descrive /user/{username}/about per le informazioni sull'account e /user/{username}/submitted e /user/{username}/comments per gli elenchi delle attività. Questi endpoint descrivono dati dell'account. Non possono verificare il nome reale, la posizione, il datore di lavoro o le convinzioni private di una persona.
Il permalink e la discussione circostante contano di solito più di una lunga esportazione del profilo. Una risposta come «ha fallito di nuovo» dice ben poco senza il commento a cui risponde. Un punteggio alto registra la reazione dei lettori in un dato momento; non misura l'accuratezza dei fatti. Distingui le parole dell'account dalle risposte di altri utenti.
Collega ogni osservazione alla fonte
Crea una riga per ogni elemento pertinente. Le voci qui sotto sono esempi inventati di una struttura dati, non risultati relativi a un account reale.
Campo | Esempio | Perché conservarlo |
|---|---|---|
|
| Eliminazione dei duplicati e controlli successivi sulle rimozioni |
|
| Distingue le risposte dai post pubblicati |
|
| Conserva il contesto della discussione |
|
| Definisce il periodo di attività |
| Link al commento | Permette a chi revisiona di consultare la discussione |
| «L'email di configurazione è arrivata in ritardo» | Riporta solo il passaggio necessario |
|
| Distingue la data di pubblicazione da quella di revisione |
| Risposta a una domanda sull'onboarding | Evita che una citazione isolata cambi significato |
| Visibile al momento del controllo | Segnala modifiche o rimozioni al controllo successivo |
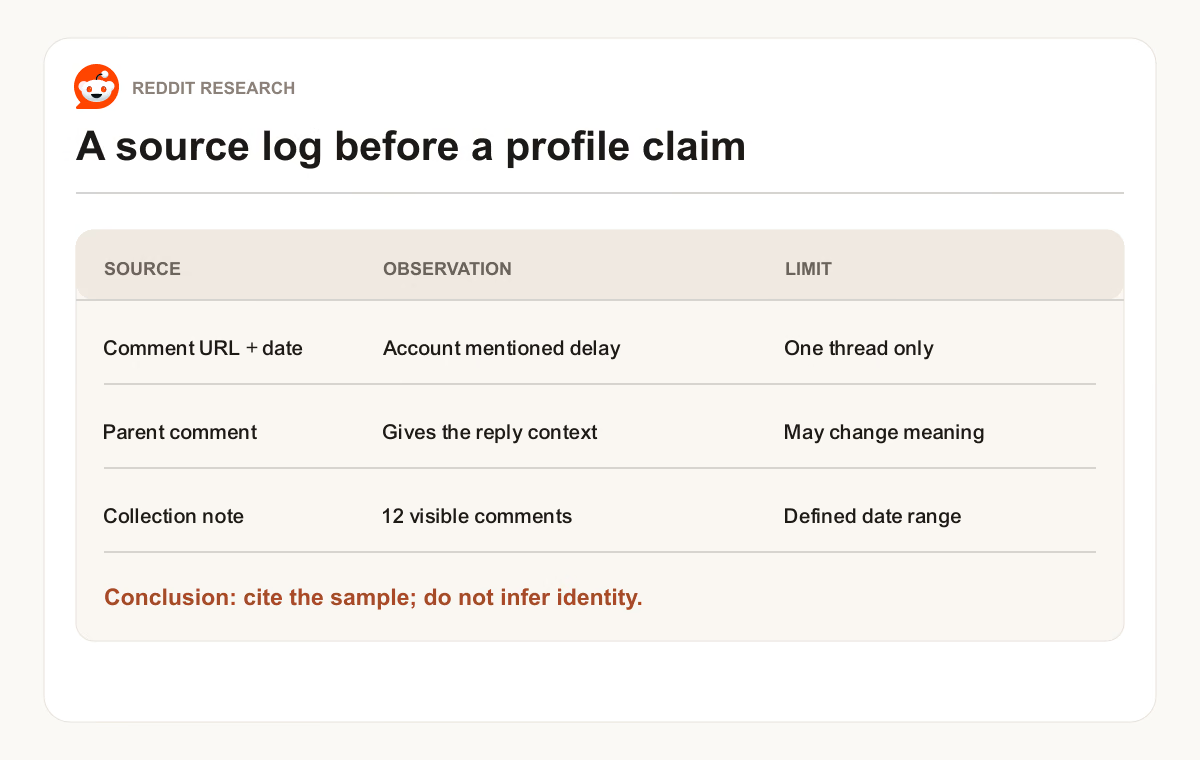
Definisci una sample_rule per il progetto, ad esempio «commenti visibili in una community durante settembre che trattano l'onboarding». Senza una regola, è facile raccogliere solo i post che confermano un'ipotesi iniziale. Escludi dal resoconto i dettagli personali non pertinenti.
Un metodo pratico per raccogliere informazioni
1. Definisci una domanda circoscritta
«Quali problemi di onboarding ha menzionato questo account in r/examplecommunity durante settembre?» definisce argomento, community e periodo. «Che tipo di persona c'è dietro questo account?» non è una domanda a cui un registro delle attività possa rispondere. Documenta lo scopo e la modalità di accesso insieme alla domanda.
2. Verifica l'accesso e documenta il metodo
Per un flusso API, richiedi l'approvazione prevista dalla Responsible Builder Policy. La Data API Wiki di Reddit specifica che i client devono usare un token OAuth registrato e un User-Agent veritiero e riconoscibile. Può bloccare il traffico non identificato. Uno script che invia un User-Agent falso da browser è quindi un cattivo consiglio, anche se restituisce una pagina.
Per pochi elementi esaminati manualmente, annota che hai usato l'interfaccia pubblica e quando hai effettuato il controllo. Documenta eventuali lacune di visibilità. Non passare di nascosto alla raccolta automatica quando la consultazione manuale diventa noiosa.
3. Raccogli solo il campione pertinente
Con un accesso API approvato, gli endpoint documentati per profili e attività restituiscono dati strutturati. La documentazione degli elenchi di Reddit usa cursori after e before invece dei numeri di pagina e indica un massimo limit di 100 elementi per risposta. Registra endpoint, ordinamento, cursore, ora della raccolta ed errori. Fermati al limite stabilito nel primo passaggio. Un elenco rappresenta una parte delle attività accessibili, non una cronologia completa certificata.
Controlla le intestazioni di risposta X-Ratelimit-Used, X-Ratelimit-Remaining, e X-Ratelimit-Reset. La API Wiki indica attualmente un limite di 100 richieste al minuto per i client OAuth idonei all'accesso gratuito, calcolato come media su un intervallo. La tua approvazione può stabilire un limite diverso: segui quello applicabile al tuo account.
4. Organizza i dati conservando le fonti
Converti created_utc in una data e ora UTC coerente. Conserva l'ID originale dell'elemento e il permalink. Indica se una riga proviene da /submitted o /comments: il titolo di un post e il corpo di una risposta sono prove diverse. Elimina i duplicati tramite l'ID dell'elemento tra una raccolta e l'altra. Conta separatamente elementi inclusi, esclusi, non disponibili e duplicati.
Se hai già una risposta autorizzata di tipo /comments per un elenco, questo piccolo esempio Python la trasforma in un CSV verificabile. Legge JSON dall'input standard e scrive CSV sull'output standard. Non recupera dati, non concede accesso e non gestisce i successivi controlli sulle cancellazioni.
import csv
import json
import sys
from datetime import datetime, timezone

listing = json.load(sys.stdin)
writer = csv.DictWriter(sys.stdout, fieldnames=[
    "item_id", "subreddit", "created_utc", "permalink", "observed_text"
])
writer.writeheader()

for child in listing["data"]["children"]:
    item = child["data"]
    body = item.get("body", "")
    if body in ("[deleted]", "[removed]"):
        continue
    writer.writerow({
        "item_id": item["name"],
        "subreddit": item["subreddit"],
        "created_utc": datetime.fromtimestamp(
            item["created_utc"], timezone.utc
        ).isoformat(),
        "permalink": "https://www.reddit.com" + item["permalink"],
        "observed_text": body,
    })
Eseguilo solo sulla risposta approvata e nel rispetto delle regole di conservazione del progetto. Prima di formulare un'affermazione, controlla la discussione a cui rimanda ciascun permalink conservato. Se manca un campo nella risposta, documenta il limite invece di inventare un valore.
Immagina una revisione circoscritta di 18 commenti visibili, di cui sei parlano di difficoltà nella configurazione. «Sei dei 18 commenti esaminati in questa community menzionavano difficoltà nella configurazione» descrive quel campione inventato. «L'utente ha spesso problemi con la tecnologia» trasforma il conteggio di un argomento in un'affermazione sulla persona. Se i sei commenti appartengono alla stessa discussione, specificalo.
5. Ricontrolla i contenuti rimossi e limita il risultato
La Data API Wiki di Reddit richiede agli utenti API di eliminare i contenuti degli utenti rimossi da Reddit che conservano e raccomanda di cancellare regolarmente i dati memorizzati entro 48 ore. La Responsible Builder Policy invita i ricercatori approvati a ripetere le query sugli export aggiornati per tenere conto delle rimozioni. Integra questo controllo in ogni flusso continuativo. Un vecchio CSV non dà un diritto permanente a conservare un testo cancellato.
In un rapporto, conserva domanda, metodo, intervallo di date, conteggi, link alle fonti ancora validi e limiti del campione. Condividi il testo grezzo solo quando necessario e consentito. Se un elemento scompare, elimina il contenuto conservato e rivedi le conclusioni che ne dipendevano.
Quando usare i diversi strumenti
requests e BeautifulSoup analizzano HTML. Playwright visualizza una pagina nel browser. PRAW fornisce un'interfaccia per parti dell'API di Reddit. Si tratta di capacità tecniche, non di permessi di accesso. Per questo argomento, il punto di partenza programmatico corretto è un flusso Data API approvato. Se hai un permesso scritto separato per lo scraping delle pagine, documentalo e rispettane l'ambito. Gli snippet dei motori di ricerca possono mostrare un URL pubblico, ma essere incompleti o obsoleti; non sostituiscono una fonte aggiornata.
Dopo la raccolta, un assistente IA può classificare un campione consentito e circoscritto. Fornisci i link alle fonti, la domanda di ricerca e l'istruzione di distinguere le deduzioni dalle osservazioni. Verifica personalmente conteggi e link. Non chiedergli di dedurre identità, salute, orientamento politico o altre caratteristiche sensibili dalla cronologia dei post; la Responsible Builder Policy di Reddit vieta espressamente questa profilazione.
La skill gratuita Reddit Profile Research fornisce una checklist riutilizzabile basata sulle prove. La skill Research Summarizer può organizzare più fonti consentite una volta completato il registro delle fonti.
Domande frequenti
Posso raccogliere dati da un profilo Reddit pubblico con Python?
La visibilità pubblica non autorizza lo scraping. L'attuale Accordo con gli utenti di Reddit limita la raccolta e vieta lo scraping senza previo consenso scritto. Usa una consultazione manuale consentita oppure ottieni l'approvazione per un'API o un'altra modalità autorizzata. Python può elaborare i dati che sei autorizzato a raccogliere; la libreria non stabilisce i diritti di accesso.
Quali endpoint API mostrano l'attività del profilo?
I profili O*NET di documentazione API di Reddit descrive /user/{username}/about, /user/{username}/submitted, e /user/{username}/comments. L'accesso dipende dall'approvazione attuale, da OAuth, dal comportamento dell'endpoint e dai termini applicabili. Gli elenchi delle attività usano cursori: documenta quindi la paginazione e la regola con cui interrompi la raccolta.
La cronologia dei commenti identifica chi gestisce l'account?
Può mostrare che cosa un account visibile ha pubblicato nel periodo esaminato. Non può verificare chi gestiva l'account. Nomi utente simili, descrizioni personali e abitudini di pubblicazione possono ingannare ed esporre qualcuno a un danno. Limita le conclusioni all'account e ai contenuti.
Cosa fare se un post viene eliminato dopo la raccolta?
Elimina i contenuti cancellati che conservi e i relativi dati identificativi dell'account, come richiesto dalle indicazioni sulle cancellazioni di Reddit. Rivedi il rapporto se quell'elemento sosteneva una conclusione. Non usare una copia salvata per ricostruire il contenuto cancellato.
Mettilo in pratica
Il prossimo passo
Hai una domanda o una correzione?
Contatta Thrive