Die Kurzfassung
- Reddit verlangt eine Data-API-Freigabe; öffentliche Sichtbarkeit erlaubt kein Scraping.
- Dokumentiere Permalinks, Zeitstempel, Kontext und Löschstatus jeder Beobachtung.
- Ein Profil ist ein begrenztes Aktivitätsprotokoll und kein Nachweis für Identität oder sensible Merkmale.
Die Auswertung öffentlicher Reddit-Profildaten erstellt ein begrenztes, überprüfbares Protokoll sichtbarer Aktivität: was ein Konto wo, wann und in welchem Thread veröffentlicht hat. Prüfe gelegentlich relevante Beiträge manuell und bewahre ihre Links auf. Hole für wiederholbare Erfassung zuerst den von Reddit verlangten API-Zugang ein. Keine Methode belegt die Identität hinter dem Konto oder erlaubt das Erstellen eines persönlichen Dossiers.
Reddit ändert seine Zugangsregeln. Die folgenden Richtlinienangaben wurden am 6. Oktober 2026 geprüft. Lies die verlinkten Bedingungen vor einem Projekt erneut.
Wähle zuerst den Zugangsweg, dann das Werkzeug
Eine Python-Bibliothek und ein Browser können Webseiten lesen. Das verleiht nicht die Rechte einer genehmigten API-Anwendung. Reddits aktuelle Nutzungsvereinbarung verbietet Scraping ohne vorherige schriftliche Zustimmung. Die Responsible Builder Policy verlangt eine ausdrückliche Freigabe für die Data API. Das Rendern einer Seite mit Playwright ändert diese Bedingungen nicht.
Zugangsweg | Geeignet für | Zuerst prüfen | Wichtigste Grenze |
|---|---|---|---|
Manuelle Prüfung in Reddit | Wenige relevante öffentliche Beiträge oder Kommentare | Sichtbarkeit und Zulässigkeit der geplanten Verwendung | Langsam; Kontext kann fehlen |
Genehmigter Data-API-Zugang | Wiederholbare, begrenzte Anwendungsabläufe | Freigabe, OAuth-Zugangsdaten, erlaubte Nutzung, Limits und Löschungen | Paginierte Listen und mögliche Zugriffsbeschränkungen |
Reddit for Researchers | Genehmigte nicht kommerzielle Forschung | Programmzulassung und Forschungsbedingungen | Außerhalb des Programms erfasste Forschungsdaten sind nach der aktuellen Richtlinie nicht erlaubt |
HTML-Scraping oder Browserautomatisierung | Eine gesondert genehmigte Nutzung | Schriftliche Erlaubnis und genauer Umfang | Anfällige Seitenstruktur; Automatisierung umgeht keine Richtlinien |
Die kommerzielle Nutzung von Reddit-Daten verlangt ausdrückliche schriftliche Freigabe. Die Responsible Builder Policy verweist Forschende auf Reddit for Researchers. Kläre vor dem Collector, ob du ein Moderationswerkzeug, eine Prüfung deines Kontos, Forschung oder eine kommerzielle Anwendung planst.
Was ein öffentliches Profil zeigen kann
Ein sichtbares Profil kann Kontonamen, Profiltext, Beiträge, Kommentare, Communities, Daten, Bewertungen und Thread-Links zeigen. Verfügbarkeit hängt von Konto und Zugang ab. Reddits API-Referenz dokumentiert /user/{username}/about für Kontoinformationen und /user/{username}/submitted und /user/{username}/comments für Aktivitätslisten. Diese Endpunkte beschreiben Kontodaten und verifizieren weder echten Namen noch Wohnort, Arbeitgeber oder private Überzeugungen.
Permalink und umgebender Thread sind meist wichtiger als ein umfangreicher Profilexport. „Es ist wieder fehlgeschlagen“ sagt ohne den übergeordneten Kommentar wenig aus. Eine hohe Bewertung zeigt Leserreaktionen zu einem Zeitpunkt und keine sachliche Richtigkeit. Trenne Kontobeiträge von Antworten anderer Nutzer.
Mache jede Beobachtung nachvollziehbar
Erstelle eine Zeile pro relevantem Eintrag. Die folgenden Angaben sind fiktive Beispiele einer Datenstruktur und keine Befunde zu einem echten Konto.
Feld | Beispiel | Grund zur Aufbewahrung |
|---|---|---|
|
| Duplikaterkennung und spätere Löschprüfungen |
|
| Trennt Antworten von eigenen Beiträgen |
|
| Erhält Diskussionskontext |
|
| Definiert den Aktivitätszeitraum |
| Link zum Kommentar | Ermöglicht die Prüfung des Threads |
| „Die Einrichtungs-E-Mail kam verspätet an“ | Erfasst nur die benötigte Textstelle |
|
| Trennt Veröffentlichungs- und Prüfzeit |
| Antwort auf eine Onboarding-Frage | Verhindert Bedeutungsänderung durch ein isoliertes Zitat |
| Bei der Prüfung sichtbar | Markiert Änderungen oder Löschungen bei erneuter Prüfung |
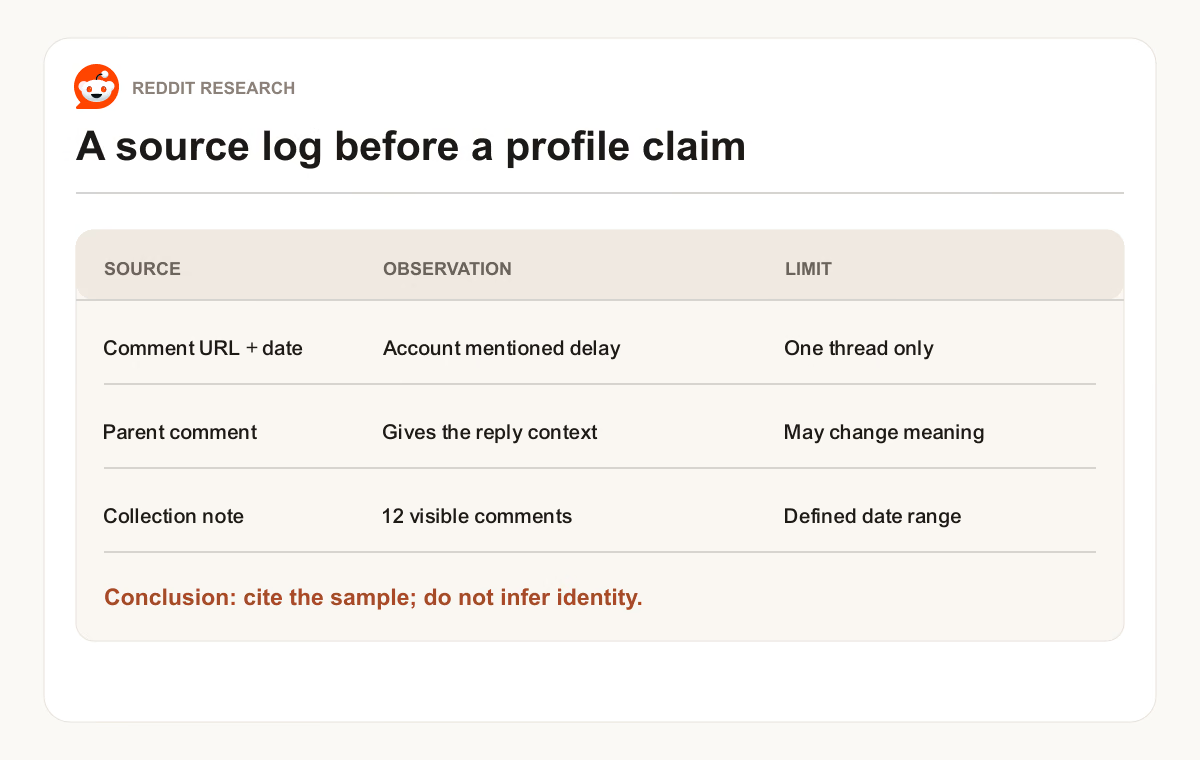
Definiere eine sample_rule für das Projekt, etwa „sichtbare Kommentare zum Onboarding in einer Community im September“. Ohne Regel werden leicht nur Beiträge gesammelt, die eine erste Vermutung stützen. Lass irrelevante persönliche Angaben weg.
Ein praktischer Ablauf zur Datenerfassung
1. Stelle eine begrenzte Frage
„Welche Onboarding-Probleme nannte dieses Konto in r/examplecommunity im September?“ definiert Thema, Community und Zeitraum. „Was für ein Mensch steckt hinter dem Konto?“ lässt sich nicht aus einem Aktivitätsprotokoll beantworten. Halte Zweck und Zugangsweg mit der Frage fest.
2. Bestätige den Zugang und dokumentiere die Methode
Beantrage für einen API-Ablauf die erforderliche Freigabe nach der Responsible Builder Policy. Reddits Data API Wiki verlangt ein registriertes OAuth-Token und einen ehrlichen, unterscheidbaren User-Agent. Unidentifizierten Verkehr kann Reddit blockieren. Ein Skript mit gefälschtem Browser-User-Agent ist deshalb kein guter Rat, auch wenn es eine Seite zurückliefert.
Notiere bei wenigen manuellen Prüfungen die Verwendung der öffentlichen Oberfläche und das Prüfdatum. Dokumentiere Sichtbarkeitslücken. Wechsle nicht unbemerkt zur automatischen Erfassung, wenn die manuelle Arbeit mühsam wird.
3. Erfasse die kleinste relevante Stichprobe
Mit genehmigtem API-Zugang liefern dokumentierte Profil- und Aktivitätsendpunkte strukturierte Daten. Reddits Dokumentation zu Listings verwendet after und before-Cursor statt Seitennummern und dokumentiert ein maximales limit von 100 Einträgen pro Antwort. Notiere Endpunkt, Sortierung, Cursor, Erfassungszeit und Fehler. Stoppe an der vorher definierten Grenze. Ein Listing ist ein Ausschnitt zugänglicher Aktivität und keine beglaubigte vollständige Historie.
Beachte die Antwort-Header X-Ratelimit-Used, den X-Ratelimit-Remaining, und X-Ratelimit-Reset. Das API Wiki beschreibt derzeit für berechtigte OAuth-Clients mit kostenlosem Zugang ein über ein Zeitfenster gemitteltes Limit von 100 Abfragen pro Minute. Deine Freigabe kann ein anderes Limit festlegen; befolge das für dein Konto geltende.
4. Vereinheitliche Daten und erhalte Quellen
Wandle created_utc in einen einheitlichen UTC-Zeitstempel um. Bewahre Original-ID und Permalink auf. Kennzeichne, ob die Zeile aus /submitted oder /comments stammt: Beitragstitel und Antworttext sind unterschiedliche Belege. Entferne Duplikate nach Eintrags-ID über mehrere Durchläufe hinweg. Zähle eingeschlossene, ausgeschlossene, nicht verfügbare und doppelte Einträge getrennt.
Wenn du bereits eine genehmigte /comments-Listing-Antwort hast, wandelt dieses kleine Python-Beispiel sie in eine prüfbare CSV um. Es liest JSON aus der Standardeingabe und schreibt CSV auf die Standardausgabe. Es ruft keine Daten ab, erteilt keinen Zugriff und behandelt keine späteren Löschprüfungen.
import csv
import json
import sys
from datetime import datetime, timezone

listing = json.load(sys.stdin)
writer = csv.DictWriter(sys.stdout, fieldnames=[
    "item_id", "subreddit", "created_utc", "permalink", "observed_text"
])
writer.writeheader()

for child in listing["data"]["children"]:
    item = child["data"]
    body = item.get("body", "")
    if body in ("[deleted]", "[removed]"):
        continue
    writer.writerow({
        "item_id": item["name"],
        "subreddit": item["subreddit"],
        "created_utc": datetime.fromtimestamp(
            item["created_utc"], timezone.utc
        ).isoformat(),
        "permalink": "https://www.reddit.com" + item["permalink"],
        "observed_text": body,
    })
Führe es nur mit der genehmigten Antwort innerhalb der Aufbewahrungsregeln aus. Prüfe den Thread jedes behaltenen Permalinks vor Aussagen. Dokumentiere fehlende Felder, statt Werte zu erfinden.
Angenommen, eine begrenzte Prüfung umfasst 18 sichtbare Kommentare; sechs nennen Schwierigkeiten bei der Einrichtung. „Sechs von 18 geprüften Kommentaren dieser Community nannten Einrichtungsschwierigkeiten“ beschreibt diese fiktive Stichprobe. „Der Nutzer hat oft Probleme mit Technik“ macht daraus eine persönliche Zuschreibung. Gehören alle sechs zu einem Thread, benenne das.
5. Prüfe Löschungen erneut und begrenze das Ergebnis
Reddits Data API Wiki verlangt von API-Nutzern das Entfernen gespeicherter, von Nutzern gelöschter Inhalte und empfiehlt regelmäßiges Leeren gespeicherter Nutzerdaten innerhalb von 48 Stunden. Die Responsible Builder Policy weist genehmigte Forschende an, Abfragen gegen aktuelle Exporte zu wiederholen, um Löschungen zu berücksichtigen. Baue diese Prüfung in laufende Abläufe ein. Eine alte CSV berechtigt nicht zur dauerhaften Aufbewahrung gelöschten Texts.
Dokumentiere Frage, Methode, Zeitraum, Zahlen, gültige Quellenlinks und Stichprobengrenzen. Teile Rohtext nur, wenn nötig und erlaubt. Entferne verschwundene Inhalte und überarbeite davon abhängige Befunde.
Welche Aufgaben gängige Werkzeuge übernehmen
requests und BeautifulSoup lesen HTML. Playwright rendert Browserseiten. PRAW kapselt Teile von Reddits API. Das sind technische Fähigkeiten, keine Zugangsrechte. Ein genehmigter Data-API-Ablauf ist der passende programmatische Einstieg. Dokumentiere gesonderte Scraping-Erlaubnis und ihren Umfang. Suchauszüge können öffentliche URLs zeigen, aber unvollständig oder veraltet sein und ersetzen keinen aktuellen Quellenbeleg.
Ein KI-Assistent kann nach der Erfassung eine erlaubte, begrenzte Stichprobe kategorisieren. Gib Quellenlinks und Forschungsfrage vor und lasse Schlussfolgerungen von Beobachtungen trennen. Prüfe Zahlen und Links selbst. Lass keine Identität, Gesundheit, Politik oder anderen sensiblen Merkmale aus Beiträgen ableiten; Reddits Responsible Builder Policy verbietet dieses Profiling ausdrücklich.
Der kostenlose Reddit Profile Research Skill bietet eine wiederverwendbare, beleggestützte Checkliste. Der Research Summarizer Skill kann mehrere erlaubte Quellen nach Abschluss des Quellenprotokolls ordnen.
Häufige Fragen
Darf ich öffentliche Reddit-Profile mit Python scrapen?
Öffentliche Sichtbarkeit erlaubt kein Scraping. Reddits aktuelle Nutzungsvereinbarung beschränkt die Erfassung und verbietet Scraping ohne vorherige schriftliche Zustimmung. Nutze zulässige manuelle Prüfungen oder genehmigte API- beziehungsweise andere Zugangswege. Python kann erlaubte Daten verarbeiten; die Bibliothek entscheidet keine Zugriffsrechte.
Welche API-Endpunkte zeigen Profilaktivität?
Die Profile für API-Referenz dokumentiert /user/{username}/about, den /user/{username}/submitted, und /user/{username}/comments. Der Zugang hängt von aktueller Freigabe, OAuth, Endpunktverhalten und Bedingungen ab. Aktivitätslisten nutzen Cursor; dokumentiere Paginierung und Stoppregel.
Identifiziert ein Kommentarverlauf die Person hinter dem Konto?
Ein Profil zeigt Beiträge eines sichtbaren Kontos im geprüften Zeitraum und verifiziert nicht seine Betreiber. Ähnliche Namen, Selbstdarstellungen und Muster können irreführen und Menschen schaden. Begrenze Schlussfolgerungen auf Konto und Inhalte.
Was passiert bei nachträglich gelöschten Beiträgen?
Entferne gespeicherte gelöschte Inhalte und zugehörige identifizierende Kontodaten gemäß Reddits Löschhinweisen. Überarbeite den Bericht, wenn der Eintrag einen Befund stützte. Nutze keine gespeicherte Kopie zur Rekonstruktion der Löschung.
Setzen Sie es in die Praxis um
Dein nächster Schritt
Hast du eine Frage oder Korrektur?
Thrive kontaktieren