La versione breve
- Stesso input → Revisione alla cieca → Costo misurato.
- Conserva le fonti e verifica il risultato prima di usarlo.
Confronta Claude Opus 5.5 e GPT-6 Sol sulle attività che vuoi affidare loro, usando gli stessi input e criteri di verifica. Le specifiche indicano limiti di accesso e prezzi dei token; per capire quale modello sia adatto al progetto serve una prova sul lavoro reale.
Thrive ha esaminato la documentazione ufficiale il 28 settembre 2026. È una guida alle specifiche e alla valutazione. Non abbiamo eseguito un benchmark comparativo, e le tabelle non contengono punteggi di prestazione inventati.
Confronta le specifiche API pubblicate
Voce | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
Fornitore | OpenAI | Anthropic |
ID del modello API | gpt-6-sol | claude-opus-5-5 |
Finestra di contesto | 1.050.000 token | 1.000.000 di token |
Output massimo | 128.000 token | 128.000 token |
Tariffa base dell'input per milione di token | 2 USD | 4 USD |
Tariffa base dell'output per milione di token | 10 USD | 20 USD |
Fonti: specifiche di GPT-6 Sol di OpenAI, panoramica dei modelli Anthropic, e prezzi API di Anthropic. Le tariffe base escludono strumenti, cache, livelli di servizio, prezzi regionali e altre condizioni. OpenAI applica tariffe maggiori oltre la soglia documentata per gli input lunghi. Verifica le condizioni di fatturazione prima di stimare il budget.
La tariffa API è separata dall'abbonamento personale. Un piano ChatGPT o Claude non offre uso API illimitato ai prezzi della tabella. Verifica il prodotto e l'account che userai.
Misura il costo di un'attività completata
Il prezzo dei token aiuta nella stima iniziale. Il costo dell'attività include anche nuovi tentativi e tempo di revisione.
Per una richiesta illustrativa con 10.000 token di input non in cache e 2.000 token di output, il costo base del testo sarebbe 0,04 USD per Sol e 0,08 USD per Opus 5.5. Il calcolo usa le tariffe della tabella e presume l'assenza di costi aggiuntivi. Sono esempi aritmetici, non fatture osservate o previsioni della quantità di testo prodotta.
Conserva i dati di consumo del fornitore per ogni prova. Tokenizzatori diversi possono contare lo stesso documento in modo diverso. Una risposta più lunga può costare più dell'esempio con output fisso.
Prova le attività che vuoi affidare al modello
Attività | Fornisci a entrambi i modelli | Verifica nel risultato |
|---|---|---|
Modifica del codice | Stessa versione del repository e stesso test che fallisce | Comportamento corretto, modifiche minime e verifiche superate |
Sintesi di ricerca | Stesse fonti e stessa domanda | Affermazioni supportate e citazioni accurate |
Revisione del curriculum | Stessi fatti verificati e stesso annuncio | Fatti preservati e tagli utili |
Revisione di un documento lungo | Stesso documento e stesse domande | Prove dalle sezioni pertinenti e lacune dichiarate |
Processo con agenti | Stessi strumenti e stessi limiti dei permessi | Azioni sicure, recupero degli errori e registro utilizzabile |
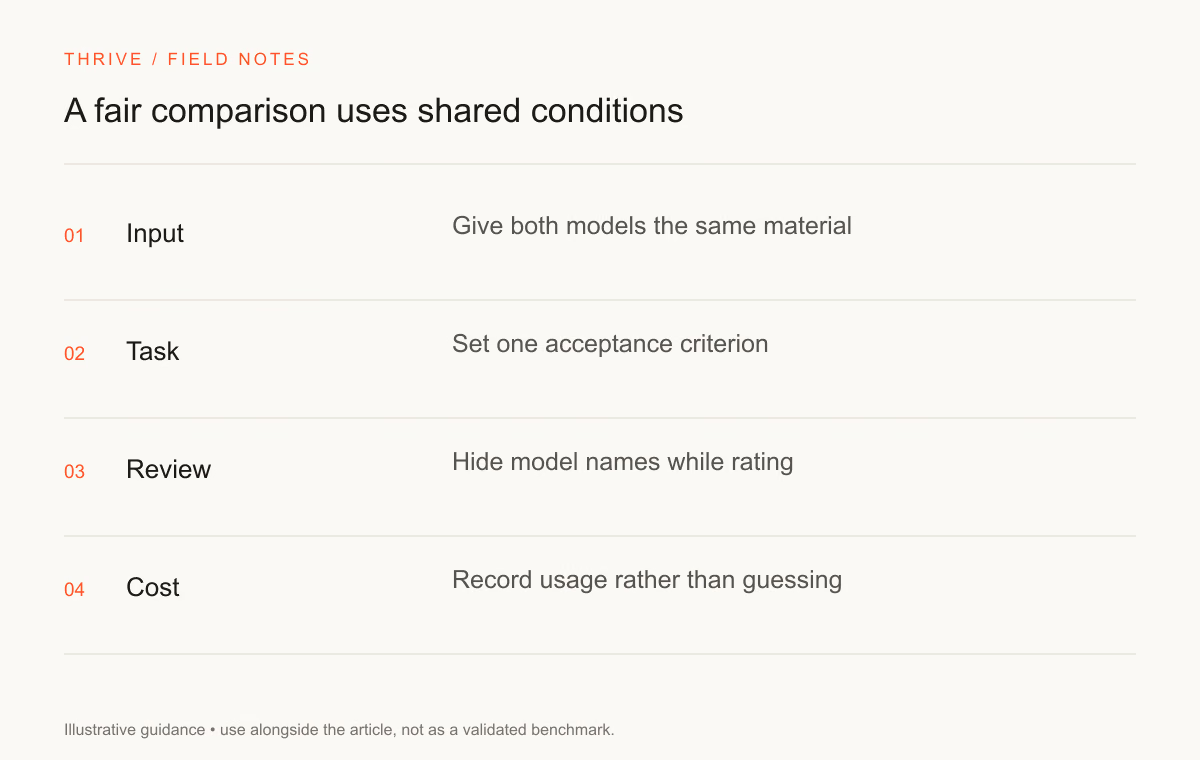
Definisci i criteri prima di leggere le risposte. Nel curriculum, fatti aggiunti devono far fallire la revisione anche se il testo è persuasivo. Nel codice, una spiegazione sicura non sostituisce un test superato.
Usa il prompt di valutazione a coppie per organizzare un primo confronto. Nascondi al revisore i nomi dei modelli quando possibile e conserva i pareggi. Registra impostazioni e accesso agli strumenti accanto al risultato.
Distingui funzioni del prodotto e comportamento del modello
Un'app web può aggiungere ricerca, recupero di file, connettori ed esportazione di documenti. Nel confronto tra app, valuta anche queste funzioni. Nel confronto tra modelli, mantieni costanti gli strumenti circostanti.
Per la ricerca, verifica che l'assistente abbia aperto la fonte e che il passaggio citato supporti l'affermazione. Per una candidatura, controlla personalmente datore di lavoro e annuncio attuale. Nessun modello dovrebbe inventare qualifiche o inviare candidature senza revisione.
I profili O*NET di guida a Claude e ChatGPT per il lavoro tratta le scelte tra prodotti. Il confronto per la programmazione offre un piano di test più circoscritto per i repository.
Scegli il modello dopo una prova circoscritta
Scegli attività rappresentative, includendo un caso che prevedi fallisca. Confronta tasso di accettazione, tempo di revisione e costi reali. Ripeti i casi importanti dopo gli aggiornamenti. Una prova circoscritta offre dati locali, non un vincitore universale.
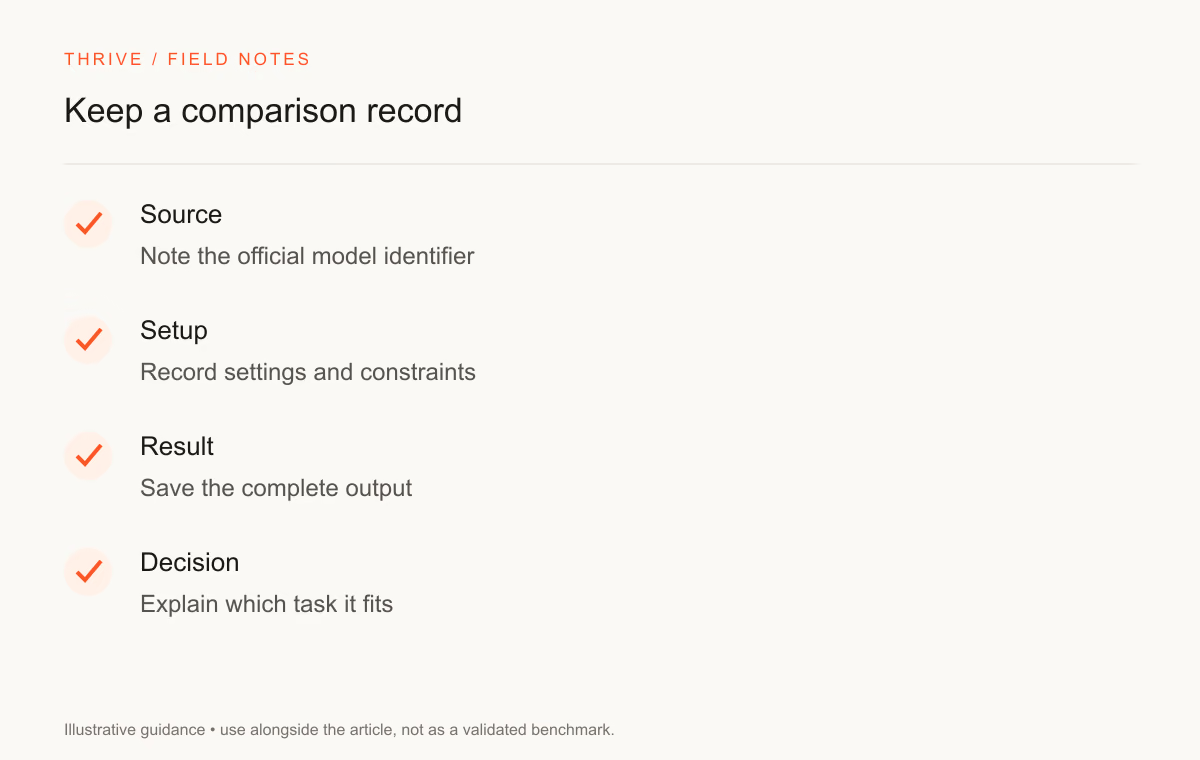
Salva prompt, fonti, ID del modello, data e note del revisore. Puoi usare la skill di valutazione dei modelli per organizzare il registro e trasformarne una versione senza dati identificativi in materiale per il portfolio.
Fonti e criteri di aggiornamento
Thrive aggiornerà questa pagina quando cambia una specifica verificata. Controlla di nuovo prezzi e disponibilità prima di acquistare o cambiare modello.
Mettilo in pratica
Il prossimo passo
Hai una domanda o una correzione?
Contatta Thrive